Thứ Sáu, 7 tháng 11, 2025

Hướng dẫn kỹ thuật lời nhắc. Kỹ thuật viết lời nhắc. Tạo sinh Tăng cường Truy xuất (RAG)


Retrieval Augmented Generation (RAG)

Theo: https://www.promptingguide.ai/techniques/rag

Các mô hình ngôn ngữ mục đích chung có thể được tinh chỉnh để đạt được vài nhiệm vụ chung chẳng hạn như phân tích cảm xúc và nhận diện thực thể được đặt tên. Các nhiệm vụ đó thường không đòi hỏi kiến thức nền tảng bổ sung.

Đối với các tác vụ phức tạp và đòi hỏi nhiều kiến thức hơn, có thể xây dựng một hệ thống dựa trên mô hình ngôn ngữ, cho phép truy cập các nguồn kiến thức bên ngoài để hoàn thành tác vụ. Điều này cho phép tính nhất quán về dữ kiện cao hơn, cải thiện độ tin cậy của các phản hồi được tạo ra và giúp giảm thiểu vấn đề "ảo giác".

Các nhà nghiên cứu Meta AI đã giới thiệu một phương pháp gọi là Tạo sinh Tăng cường Truy xuất - RAG (Retrieval Augmented Generation) để giải quyết các tác vụ đòi hỏi nhiều kiến thức như vậy. RAG kết hợp một thành phần truy xuất thông tin với một mô hình tạo sinh văn bản. RAG có thể được tinh chỉnh và kiến thức nội bộ của nó có thể được sửa đổi một cách hiệu quả mà không cần phải đào tạo lại toàn bộ mô hình.

RAG lấy dữ liệu đầu vào và truy xuất một tập hợp các tài liệu liên quan/hỗ trợ dựa trên một nguồn (ví dụ: Wikipedia). Các tài liệu được nối theo ngữ cảnh với lời nhắc nhập ban đầu và được đưa vào trình tạo sinh văn bản, nơi tạo ra kết quả cuối cùng. Điều này làm cho RAG thích ứng với các tình huống mà dữ kiện có thể thay đổi theo thời gian. Điều này rất hữu ích vì kiến thức tham số của LLM là tĩnh. RAG cho phép các mô hình ngôn ngữ bỏ qua việc đào tạo lại, cho phép truy cập thông tin mới nhất để tạo sinh các đầu ra đáng tin cậy thông qua phương pháp tạo sinh dựa trên truy xuất.

Lewis và cộng sự, (2021) đã đề xuất một công thức tinh chỉnh đa năng cho RAG. Một mô hình seq2seq được đào tạo trước được sử dụng làm bộ nhớ tham số và một chỉ mục vectơ dày đặc của Wikipedia được sử dụng làm bộ nhớ phi tham số (được truy cập bằng bộ truy xuất thần kinh được đào tạo trước). Dưới đây là tổng quan về cách thức hoạt động của phương pháp này:


Image Source: Lewis et el. (2021)

RAG hoạt động mạnh mẽ trên một số tiêu chuẩn như Natural Questions, WebQuestions và CuratedTrec. RAG tạo ra các câu trả lời thực tế, cụ thể và đa dạng hơn khi được kiểm tra trên các câu hỏi MS-MARCO và Jeopardy. RAG cũng cải thiện kết quả xác minh dữ kiện FEVER.

Điều này cho thấy tiềm năng của RAG như một lựa chọn khả thi để cải thiện kết quả của các mô hình ngôn ngữ trong các nhiệm vụ đòi hỏi kiến thức chuyên sâu.

Gần đây, các phương pháp tiếp cận dựa trên bộ truy xuất này đã trở nên phổ biến hơn và được kết hợp với các chương trình LLM phổ biến như ChatGPT để cải thiện khả năng và tính nhất quán của dữ kiện.

Trường hợp sử dụng RAG: Tạo sinh tiêu đề bài báo học máy thân thiện

Dưới đây, chúng tôi đã chuẩn bị một hướng dẫn sổ tay giới thiệu việc sử dụng các Mô hình Ngôn ngữ Lớn - LLM (Large Language Model) nguồn mở để xây dựng hệ thống RAG nhằm tạo sinh tiêu đề bài báo học máy ngắn gọn và súc tích:

Tài liệu tham khảo

Về ‘Kỹ thuật viết lời nhắc’ ………. Phần trước ………. Phần tiếp theo

General-purpose language models can be fine-tuned to achieve several common tasks such as sentiment analysis and named entity recognition. These tasks generally don't require additional background knowledge.

For more complex and knowledge-intensive tasks, it's possible to build a language model-based system that accesses external knowledge sources to complete tasks. This enables more factual consistency, improves reliability of the generated responses, and helps to mitigate the problem of "hallucination".

Meta AI researchers introduced a method called Retrieval Augmented Generation (RAG) to address such knowledge-intensive tasks. RAG combines an information retrieval component with a text generator model. RAG can be fine-tuned and its internal knowledge can be modified in an efficient manner and without needing retraining of the entire model.

RAG takes an input and retrieves a set of relevant/supporting documents given a source (e.g., Wikipedia). The documents are concatenated as context with the original input prompt and fed to the text generator which produces the final output. This makes RAG adaptive for situations where facts could evolve over time. This is very useful as LLMs's parametric knowledge is static. RAG allows language models to bypass retraining, enabling access to the latest information for generating reliable outputs via retrieval-based generation.

Lewis et al., (2021) proposed a general-purpose fine-tuning recipe for RAG. A pre-trained seq2seq model is used as the parametric memory and a dense vector index of Wikipedia is used as non-parametric memory (accessed using a neural pre-trained retriever). Below is a overview of how the approach works:

RAG performs strong on several benchmarks such as Natural Questions, WebQuestions, and CuratedTrec. RAG generates responses that are more factual, specific, and diverse when tested on MS-MARCO and Jeopardy questions. RAG also improves results on FEVER fact verification.

This shows the potential of RAG as a viable option for enhancing outputs of language models in knowledge-intensive tasks.

More recently, these retriever-based approaches have become more popular and are combined with popular LLMs like ChatGPT to improve capabilities and factual consistency.

RAG Use Case: Generating Friendly ML Paper Titles

Below, we have prepared a notebook tutorial showcasing the use of open-source LLMs to build a RAG system for generating short and concise machine learning paper titles:

References

Dịch: Lê Trung Nghĩa

letrungnghia.foss@gmail.com

Thứ Năm, 6 tháng 11, 2025

Hướng dẫn kỹ thuật lời nhắc. Kỹ thuật viết lời nhắc. Cây tư duy (ToT)


Tree of Thoughts (ToT)

Theo: https://www.promptingguide.ai/techniques/tot

Đối với các nhiệm vụ phức tạp đòi hỏi sự khám phá hoặc tầm nhìn chiến lược, các kỹ thuật gợi ý truyền thống hoặc đơn giản không hiệu quả. Yao và cộng sự (2023) và Long (2023) gần đây đã đề xuất Cây Tư Duy - ToT (Tree of Thoughts), một khung khái quát hóa việc gợi ý theo chuỗi tư duy và khuyến khích việc khám phá các tư duy đóng vai trò là các bước trung gian để giải quyết vấn đề chung bằng mô hình ngôn ngữ.

ToT duy trì một cây tư duy, trong đó các tư duy đại diện cho các chuỗi ngôn ngữ mạch lạc đóng vai trò là các bước trung gian hướng tới việc giải quyết vấn đề. Cách tiếp cận này cho phép một LM tự đánh giá tiến trình thông qua các tư duy trung gian được tạo ra để giải quyết vấn đề thông qua một quá trình suy luận có chủ đích. Khả năng tạo ra và đánh giá các tư duy của LM sau đó được kết hợp với các thuật toán tìm kiếm (ví dụ: tìm kiếm theo chiều rộng và tìm kiếm theo chiều sâu) để cho phép khám phá các tư duy một cách có hệ thống bằng cách nhìn về phía trước và quay lại phía sau.

Khung ToT được minh họa dưới đây:


Image Source: Yao et el. (2023)

Khi sử dụng ToT, các nhiệm vụ khác nhau yêu cầu xác định số lượng ứng viên và số lượng suy nghĩ/bước. Ví dụ, như đã trình bày trong bài báo, Trò chơi 24 được sử dụng như một bài toán suy luận toán học, yêu cầu phân tích các suy nghĩ thành 3 bước, mỗi bước bao gồm một phương trình trung gian. Ở mỗi bước, các ứng viên tốt nhất với b=5 sẽ được giữ lại.

Để thực hiện BFS trong ToT cho nhiệm vụ Trò chơi 24, LM được yêu cầu đánh giá từng ứng viên suy nghĩ là "chắc chắn/có thể/không thể" liên quan đến việc đạt đến 24. Như các tác giả đã nêu, "mục tiêu là thúc đẩy các giải pháp từng phần đúng có thể được đưa ra phán đoán trong vài lần thử nhìn trước, và loại bỏ các giải pháp từng phần không thể dựa trên lý lẽ thông thường "quá lớn/quá nhỏ", và giữ phần còn lại là "có thể". Các giá trị được lấy mẫu 3 lần cho mỗi suy nghĩ. Minh họa quy trình như dưới đây:


Nguồn ảnh: Yao et el. (2023)

Từ các kết quả được báo cáo trong hình bên dưới, ToT vượt trội hơn đáng kể so với các phương pháp nhắc khác:


Image Source: Yao et el. (2023)

Mã có sẵn tại đây và tại đây

Ở cấp độ cao, các ý tưởng chính của Yao và cộng sự (2023) và Long (2023) khá tương đồng. Cả hai đều nâng cao khả năng giải quyết các vấn đề phức tạp của LLM thông qua tìm kiếm cây thông qua một cuộc trò chuyện nhiều vòng. Một trong những điểm khác biệt chính là Yao và cộng sự (2023) tận dụng tìm kiếm DFS/BFS/beam, trong khi chiến lược tìm kiếm cây (tức là khi nào cần quay lui và quay lui theo bao nhiêu cấp, v.v.) được đề xuất trong Long (2023) được điều khiển bởi một "Bộ điều khiển ToT" được đào tạo thông qua học tăng cường. Tìm kiếm DFS/BFS/Beam là các chiến lược tìm kiếm giải pháp chung chung, không thích ứng với các bài toán cụ thể. Ngược lại, một Bộ điều khiển ToT được đào tạo thông qua RL có thể học hỏi từ tập dữ liệu mới hoặc thông qua tự chơi (AlphaGo so với tìm kiếm tấn công thô bạo - brute force), và do đó hệ thống ToT dựa trên RL có thể tiếp tục phát triển và học hỏi kiến thức mới ngay cả với một LLM cố định.

Hulbert (2023) đã đề xuất Phương pháp Lời nhắc theo Cây Tư duy (Tree-of-Thought Prompting), áp dụng khái niệm chính từ các khuôn khổ ToT như một kỹ thuật gợi ý đơn giản, giúp LLM đánh giá các suy nghĩ trung gian chỉ trong một lời nhắc. Một ví dụ về gợi ý ToT là:

Hãy tưởng tượng ba chuyên gia khác nhau đang trả lời câu hỏi này.
Tất cả các chuyên gia sẽ viết ra 1 bước suy nghĩ của mình,
sau đó chia sẻ với cả nhóm.
Sau đó, tất cả các chuyên gia sẽ chuyển sang bước tiếp theo, v.v.
Nếu bất kỳ chuyên gia nào nhận ra mình sai ở bất kỳ điểm nào, họ sẽ rời đi.
Câu hỏi là…

Sun (2023) đã đánh giá Cây tư duy bằng các thí nghiệm quy mô lớn và giới thiệu PanelGPT --- một ý tưởng về việc gợi ý trong các cuộc thảo luận nhóm giữa các LLM.

Về ‘Kỹ thuật viết lời nhắc’ ………. Phần trước ………. Phần tiếp theo

For complex tasks that require exploration or strategic lookahead, traditional or simple prompting techniques fall short. Yao et el. (2023) and Long (2023) recently proposed Tree of Thoughts (ToT), a framework that generalizes over chain-of-thought prompting and encourages exploration over thoughts that serve as intermediate steps for general problem solving with language models.

ToT maintains a tree of thoughts, where thoughts represent coherent language sequences that serve as intermediate steps toward solving a problem. This approach enables an LM to self-evaluate the progress through intermediate thoughts made towards solving a problem through a deliberate reasoning process. The LM's ability to generate and evaluate thoughts is then combined with search algorithms (e.g., breadth-first search and depth-first search) to enable systematic exploration of thoughts with lookahead and backtracking.

The ToT framework is illustrated below:

When using ToT, different tasks requires defining the number of candidates and the number of thoughts/steps. For instance, as demonstrated in the paper, Game of 24 is used as a mathematical reasoning task which requires decomposing the thoughts into 3 steps, each involving an intermediate equation. At each step, the best b=5 candidates are kept.

To perform BFS in ToT for the Game of 24 task, the LM is prompted to evaluate each thought candidate as "sure/maybe/impossible" with regard to reaching 24. As stated by the authors, "the aim is to promote correct partial solutions that can be verdicted within few lookahead trials, and eliminate impossible partial solutions based on "too big/small" commonsense, and keep the rest "maybe"". Values are sampled 3 times for each thought. The process is illustrated below:

From the results reported in the figure below, ToT substantially outperforms the other prompting methods:

Code available here and here

At a high level, the main ideas of Yao et el. (2023) and Long (2023) are similar. Both enhance LLM's capability for complex problem solving through tree search via a multi-round conversation. One of the main difference is that Yao et el. (2023) leverages DFS/BFS/beam search, while the tree search strategy (i.e. when to backtrack and backtracking by how many levels, etc.) proposed in Long (2023) is driven by a "ToT Controller" trained through reinforcement learning. DFS/BFS/Beam search are generic solution search strategies with no adaptation to specific problems. In comparison, a ToT Controller trained through RL might be able learn from new data set or through self-play (AlphaGo vs brute force search), and hence the RL-based ToT system can continue to evolve and learn new knowledge even with a fixed LLM.

Hulbert (2023) has proposed Tree-of-Thought Prompting, which applies the main concept from ToT frameworks as a simple prompting technique, getting the LLM to evaluate intermediate thoughts in a single prompt. A sample ToT prompt is:

Imagine three different experts are answering this question.
All experts will write down 1 step of their thinking,
then share it with the group.
Then all experts will go on to the next step, etc.
If any expert realises they're wrong at any point then they leave.
The question is...

Sun (2023) benchmarked the Tree-of-Thought Prompting with large-scale experiments, and introduce PanelGPT --- an idea of prompting with Panel discussions among LLMs.

Dịch: Lê Trung Nghĩa

letrungnghia.foss@gmail.com

Thứ Tư, 5 tháng 11, 2025

Hướng dẫn kỹ thuật lời nhắc. Kỹ thuật viết lời nhắc. Chuỗi lời nhắc


Prompt Chaining

Theo: https://www.promptingguide.ai/techniques/prompt_chaining

Giới thiệu Chuỗi lời nhắc


Video: Chuỗi lời nhắc với GPT-4o và Flowise AI (Sách hướng dẫn)

Để cải thiện độ tin cậy và hiệu suất của LLM, một trong những kỹ thuật thiết kế lời nhắc quan trọng là chia nhỏ tác vụ thành các tác vụ con. Khi các tác vụ con đó đã được xác định, LLM sẽ được nhắc nhở bằng một tác vụ con và sau đó phản hồi của nó được sử dụng làm đầu vào cho một lời nhắc khác. Đây chính là phương pháp xâu chuỗi lời nhắc, trong đó một tác vụ được chia thành các tác vụ con với mục đích tạo ra một chuỗi các thao tác nhắc.

Xâu chuỗi lời nhắc rất hữu ích để hoàn thành các tác vụ phức tạp mà LLM có thể gặp khó khăn khi được nhắc bằng một lời nhắc quá chi tiết. Trong việc xâu chuỗi nhắc nhở, các lời nhắc chuỗi thực hiện các chuyển đổi hoặc quy trình bổ sung dựa trên các phản hồi được tạo ra trước khi đạt đến trạng thái mong muốn cuối cùng.

Bên cạnh việc đạt được hiệu suất tốt hơn, việc xâu chuỗi lời nhắc còn giúp tăng cường tính minh bạch của ứng dụng LLM, tăng khả năng kiểm soát và độ tin cậy. Điều này có nghĩa là bạn có thể gỡ lỗi các vấn đề với phản hồi của mô hình dễ dàng hơn nhiều, đồng thời phân tích và cải thiện hiệu suất trong các giai đoạn khác nhau cần cải thiện.

Xâu chuỗi lời nhắc đặc biệt hữu ích khi xây dựng các trợ lý đàm thoại được LLM hỗ trợ và cải thiện tính cá nhân hóa cũng như trải nghiệm người dùng trong ứng dụng của bạn.

Các trường hợp sử dụng cho chuỗi lời nhắc

Chuỗi nhắc cho QA tài liệu

Chuỗi lời nhắc có thể được sử dụng trong các tình huống khác nhau, bao gồm nhiều thao tác hoặc chuyển đổi. Ví dụ, một trường hợp sử dụng phổ biến của LLM liên quan đến việc trả lời các câu hỏi về một tài liệu văn bản lớn. Sẽ rất hữu ích nếu bạn thiết kế hai lời nhắc khác nhau, trong đó lời nhắc đầu tiên chịu trách nhiệm trích xuất các trích dẫn liên quan để trả lời câu hỏi và lời nhắc thứ hai lấy dữ liệu đầu vào là các trích dẫn và tài liệu gốc để trả lời câu hỏi cho trước. Nói cách khác, bạn sẽ tạo hai lời nhắc khác nhau để thực hiện nhiệm vụ trả lời một câu hỏi được đưa ra trong tài liệu.

Lời nhắc đầu tiên bên dưới trích xuất các trích dẫn liên quan từ tài liệu được đưa ra cho câu hỏi. Lưu ý rằng để đơn giản, chúng tôi đã thêm một trình giữ chỗ cho tài liệu {{document}}. Để kiểm tra lời nhắc, bạn có thể sao chép và dán một bài viết từ Wikipedia, chẳng hạn như trang này, để thiết kế lời nhắc. Do ngữ cảnh được sử dụng rộng hơn cho nhiệm vụ này, chúng tôi đang sử dụng mô hình gpt-4-1106-preview từ OpenAI. Bạn có thể sử dụng lời nhắc này với các LLM ngữ cảnh dài khác như Claude.

Prompt 1:

Bạn là một trợ lý hữu ích. Nhiệm vụ của bạn là giúp trả lời một câu hỏi được đưa ra trong tài liệu. Bước đầu tiên là trích xuất các trích dẫn liên quan đến câu hỏi từ tài liệu, được phân cách bằng ####. Vui lòng xuất danh sách trích dẫn bằng <quotes></quotes>. Trả lời "Không tìm thấy trích dẫn liên quan!" nếu không tìm thấy trích dẫn liên quan.
####
{{document}}
####

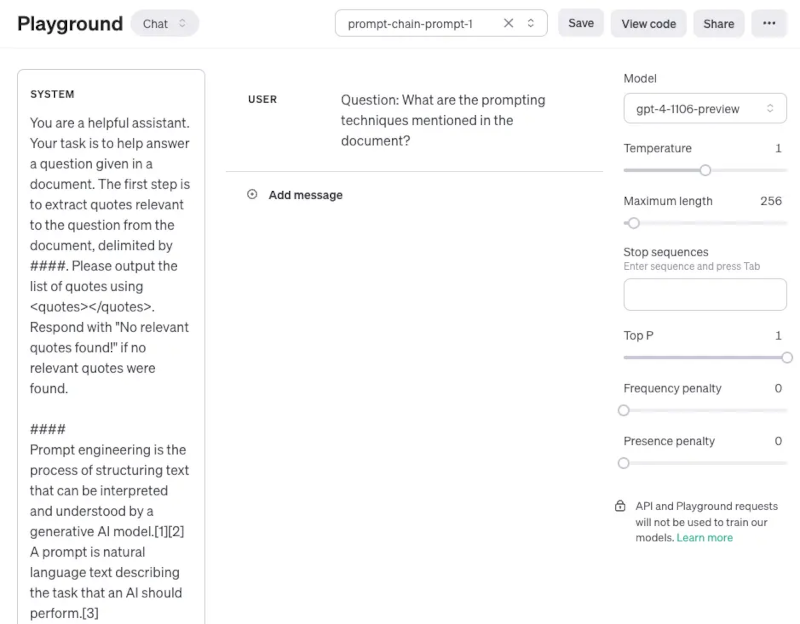
Sau đây là ảnh chụp màn hình toàn bộ lời nhắc bao gồm câu hỏi được truyền bằng việc sử dụng vai trò của người dùng.

Output of Prompt 1:

<quotes>
- Lời nhắc chuỗi suy nghĩ (CoT)[27]
- Lời nhắc kiến thức được tạo ra[37]
- Lời nhắc từ ít nhất đến nhiều nhất[38]
- Giải mã tính tự nhất quán[39]
- Lời nhắc dựa trên độ phức tạp[41]
- Tự tinh chỉnh[42]
- Lời nhắc cây suy nghĩ[43]
- Lời nhắc Maieutic[45]
- Lời nhắc kích thích định hướng[46]
- Đảo ngược văn bản và nhúng[59]
- Sử dụng giảm dần độ dốc để tìm kiếm lời nhắc[61][62][63][64]
- Chèn lời nhắc[65][66][67]
</quotes>


Các trích dẫn được trả về trong lời nhắc đầu tiên giờ đây có thể được sử dụng làm đầu vào cho lời nhắc thứ hai bên dưới. Lưu ý rằng bạn có thể dọn dẹp các trích dẫn thêm một chút, tức là xóa các trích dẫn. Các trích dẫn đó có thể được xóa hoặc sử dụng như một phần của một lời nhắc khác trong chuỗi, nhưng bạn có thể bỏ qua điều này ngay bây giờ. Lời nhắc thứ hai sau đó sẽ lấy các trích dẫn liên quan được trích xuất bởi lời nhắc 1 và chuẩn bị một câu trả lời hữu ích cho câu hỏi được đưa ra trong tài liệu và các trích dẫn được trích xuất đó. Lời nhắc thứ hai có thể như sau:

Prompt 2:

Cho một tập hợp các trích dẫn liên quan (được phân cách bằng <quotes></quotes>) được trích xuất từ một tài liệu và tài liệu gốc (được phân cách bằng ####), vui lòng soạn câu trả lời cho câu hỏi. Đảm bảo câu trả lời chính xác, có giọng điệu thân thiện và hữu ích.

####
{{document}}
####

<quotes>
- Lời nhắc chuỗi suy nghĩ (CoT)[27]
- Lời nhắc kiến thức được tạo ra[37]
- Lời nhắc từ ít nhất đến nhiều nhất[38]
- Giải mã tính nhất quán tự thân[39]
- Lời nhắc dựa trên độ phức tạp[41]
- Tự tinh chỉnh[42]
- Lời nhắc cây suy nghĩ[43]
- Lời nhắc Maieutic[45]
- Lời nhắc kích thích định hướng[46]
- Đảo ngược văn bản và nhúng[59]
- Sử dụng gradient descent để tìm kiếm lời nhắc [61][62][63][64]
- Chèn lời nhắc [65][66][67]
</quotes>

Đầu ra của Lời nhắc 2: (Output of Prompt 2:)

Các kỹ thuật nhắc được nêu trong tài liệu này bao gồm: 
1. Lời nhắc chuỗi tư duy (CoT) [27]
2. Lời nhắc kiến thức được tạo ra [37]
3. Lời nhắc từ ít nhất tới nhiều nhất [38]
4. Giải mã tự nhất quán [39]
5. Lời nhắc dựa trên sự phức tạp [41]
6. Tự tinh chỉnh [42]
7. Lời nhắc Cây tư duy [43]
8. Lời nhắc Maieutic[45]
9. Lời nhắc kích thích định hướng [46]
10. Đảo ngược văn bản và nhúng [59]
11. Sử dụng độ dốc giảm dần để tìm kiếm các lời nhắc [61][62][63][64]
12. Chèn lời nhắc [65][66][67]

Mỗi kỹ thuật này sử dụng các chiến lược riêng để tăng cường hoặc chỉ định các tương tác với các mô hình ngôn ngữ lớn nhằm tạo ra kết quả mong muốn.

Như bạn thấy, việc đơn giản hóa và tạo chuỗi lời nhắc là một phương pháp nhắc hữu ích khi các phản hồi cần trải qua nhiều thao tác hoặc chuyển đổi. Để thực hành, bạn có thể thiết kế một lời nhắc loại bỏ các trích dẫn (ví dụ: [27]) khỏi phản hồi trước khi gửi phản hồi này dưới dạng phản hồi cuối cùng cho người dùng ứng dụng của bạn.

Bạn cũng có thể tìm thêm các ví dụ về chuỗi lời nhắc trong tài liệu này, sử dụng Claude LLM. Ví dụ của chúng tôi được lấy cảm hứng và điều chỉnh từ các ví dụ của họ.

Về ‘Kỹ thuật viết lời nhắc’ ………. Phần trước ………. Phần tiếp theo

Video: Prompt Chaining with GPT-4o and Flowise AI (Tutorial)

Introduction to Prompt Chaining

To improve the reliability and performance of LLMs, one of the important prompt engineering techniques is to break tasks into its subtasks. Once those subtasks have been identified, the LLM is prompted with a subtask and then its response is used as input to another prompt. This is what's referred to as prompt chaining, where a task is split into subtasks with the idea to create a chain of prompt operations.

Prompt chaining is useful to accomplish complex tasks which an LLM might struggle to address if prompted with a very detailed prompt. In prompt chaining, chain prompts perform transformations or additional processes on the generated responses before reaching a final desired state.

Besides achieving better performance, prompt chaining helps to boost the transparency of your LLM application, increases controllability, and reliability. This means that you can debug problems with model responses much more easily and analyze and improve performance in the different stages that need improvement.

Prompt chaining is particularly useful when building LLM-powered conversational assistants and improving the personalization and user experience of your applications.

Use Cases for Prompt Chaining

Prompt Chaining for Document QA

Prompt chaining can be used in different scenarios that could involve several operations or transformations. For instance, one common use case of LLMs involves answering questions about a large text document. It helps if you design two different prompts where the first prompt is responsible for extracting relevant quotes to answer a question and a second prompt takes as input the quotes and original document to answer a given question. In other words, you will be creating two different prompts to perform the task of answering a question given in a document.

The first prompt below extracts the relevant quotes from the document given the question. Note that for simplicity, we have added a placeholder for the document {{document}}. To test the prompt you can copy and paste an article from Wikipedia such as this page for prompt engineering. Due to larger context used for this task, we are using the gpt-4-1106-preview model from OpenAI. You can use the prompt with other long-context LLMs like Claude.

Prompt 1:

You are a helpful assistant. Your task is to help answer a question given in a document. The first step is to extract quotes relevant to the question from the document, delimited by ####. Please output the list of quotes using <quotes></quotes>. Respond with "No relevant quotes found!" if no relevant quotes were found.


####
{{document}}
####

Here is a screenshot of the entire prompt including the question which is passed using the user role.

Output of Prompt 1:

<quotes>
- Chain-of-thought (CoT) prompting[27]
- Generated knowledge prompting[37]
- Least-to-most prompting[38]
- Self-consistency decoding[39]
- Complexity-based prompting[41]
- Self-refine[42]
- Tree-of-thought prompting[43]
- Maieutic prompting[45]
- Directional-stimulus prompting[46]
- Textual inversion and embeddings[59]
- Using gradient descent to search for prompts[61][62][63][64]
- Prompt injection[65][66][67]
</quotes>

The quotes that were returned in the first prompt can now be used as input to the second prompt below. Note that you can clean up the quotes a bit more, i.e., remove the citations. Those citations could be removed or utilized as part of another prompt in the chain but you can ignore this for now. The second prompt then takes the relevant quotes extracted by prompt 1 and prepares a helpful response to the question given in the document and those extracted quotes. The second prompt can be the following:

Prompt 2:

Given a set of relevant quotes (delimited by <quotes></quotes>) extracted from a document and the original document (delimited by ####), please compose an answer to the question. Ensure that the answer is accurate, has a friendly tone, and sounds helpful.

####
{{document}}
####

<quotes>
- Chain-of-thought (CoT) prompting[27]
- Generated knowledge prompting[37]
- Least-to-most prompting[38]
- Self-consistency decoding[39]
- Complexity-based prompting[41]
- Self-refine[42]
- Tree-of-thought prompting[43]
- Maieutic prompting[45]
- Directional-stimulus prompting[46]
- Textual inversion and embeddings[59]
- Using gradient descent to search for prompts[61][62][63][64]
- Prompt injection[65][66][67]
</quotes>

Output of Prompt 2:

The prompting techniques mentioned in the document include:

1. Chain-of-thought (CoT) prompting[27]
2. Generated knowledge prompting[37]
3. Least-to-most prompting[38]
4. Self-consistency decoding[39]
5. Complexity-based prompting[41]
6. Self-refine[42]
7. Tree-of-thought prompting[43]
8. Maieutic prompting[45]
9. Directional-stimulus prompting[46]
10. Textual inversion and embeddings[59]
11. Using gradient descent to search for prompts[61][62][63][64]
12. Prompt injection[65][66][67]

Each of these techniques employs unique strategies to enhance or specify the interactions with large language models to produce the desired outcomes.

As you can see, simplifying and creating prompt chains is a useful prompting approach where the responses need to undergo several operations or transformations. As an exercise, feel free to design a prompt that removes the citations (e.g., [27]) from the response before sending this as a final response to the user of your application.

You can also find more examples of prompt chaining in this documentation that leverages the Claude LLM. Our example is inspired and adapted from their examples.

Dịch: Lê Trung Nghĩa

letrungnghia.foss@gmail.com


Thứ Ba, 4 tháng 11, 2025

Hướng dẫn kỹ thuật lời nhắc. Kỹ thuật viết lời nhắc. Lời nhắc kiến thức được tạo


Generated Knowledge Prompting

Theo: https://www.promptingguide.ai/techniques/knowledge

Image Source: Liu et al. 2022

Các mô hình ngôn ngữ lớn (LLM) tiếp tục được cải tiến và một kỹ thuật phổ biến bao gồm khả năng kết hợp kiến thức hoặc thông tin để giúp mô hình đưa ra dự đoán chính xác hơn.

Sử dụng một ý tưởng tương tự, liệu mô hình có thể được sử dụng để tạo ra kiến thức trước khi đưa ra dự đoán hay không? Đó là những gì được Liu và cộng sự thực hiện trong bài báo năm 2022 -- tạo ra kiến thức để sử dụng như một phần của gợi ý. Cụ thể, điều này hữu ích như thế nào đối với các nhiệm vụ như suy luận theo lẽ thường?

Hãy thử một lời nhắc đơn giản:

Prompt:

Một phần của golf là cố gắng đạt tổng điểm cao hơn người khác. Có hay không?

Output:

Có.

Loại sai lầm này cho thấy những hạn chế của LLM trong việc thực hiện các nhiệm vụ đòi hỏi nhiều kiến thức hơn về thế giới. Làm thế nào để chúng ta cải thiện điều này bằng cách tạo ra kiến thức?

Đầu tiên, chúng ta tạo ra một vài "kiến thức":

Prompt:

Đầu vào: Hy Lạp lớn hơn Mexico.
Kiến thức: Hy Lạp có diện tích khoảng 131.957 km², trong khi Mexico có diện tích khoảng 1.964.375 km², khiến Mexico lớn hơn Hy Lạp 1.389%. 

Đầu vào: Kính luôn bị mờ.
Kiến thức: Sự ngưng tụ xảy ra trên tròng kính khi hơi nước từ mồ hôi, hơi thở và độ ẩm môi trường của bạn tiếp xúc với bề mặt lạnh, nguội đi và sau đó biến thành những giọt chất lỏng nhỏ, tạo thành một lớp màng mà bạn nhìn thấy dưới dạng sương mù. Tròng kính của bạn sẽ tương đối mát so với hơi thở của bạn, đặc biệt là khi không khí bên ngoài lạnh.

Đầu vào: Cá có khả năng suy nghĩ.
Kiến thức: Cá thông minh hơn vẻ bề ngoài của chúng. Trong nhiều lĩnh vực, chẳng hạn như trí nhớ, khả năng nhận thức của chúng ngang bằng hoặc vượt trội hơn các loài động vật có xương sống 'cao cấp', bao gồm cả linh trưởng không phải người. Trí nhớ dài hạn của cá giúp chúng theo dõi các mối quan hệ xã hội phức tạp.

Đầu vào: Một tác động phổ biến của việc hút nhiều thuốc lá trong đời là nguy cơ mắc ung thư phổi cao hơn bình thường.
Kiến thức: Những người hút trung bình ít hơn một điếu thuốc mỗi ngày trong suốt cuộc đời có nguy cơ tử vong vì ung thư phổi cao gấp chín lần so với những người không bao giờ hút thuốc. Trong số những người hút từ một đến 10 điếu thuốc mỗi ngày, nguy cơ tử vong vì ung thư phổi cao hơn gần 12 lần so với những người không bao giờ hút thuốc.

Đầu vào: Một hòn đá có kích thước tương đương với một viên sỏi.
Kiến thức: Một viên sỏi là một mảnh đá có kích thước hạt từ 4 đến 64 mm dựa trên thang trầm tích Udden-Wentworth. Sỏi thường được coi là lớn hơn hạt nhỏ (đường kính từ 2 đến 4 mm) và nhỏ hơn đá cuội (đường kính từ 64 đến 256 mm).

Đầu vào: Một phần của môn golf là cố gắng đạt tổng điểm cao hơn những người khác.
Kiến thức:

Knowledge 1:

Mục đích của golf là chơi một loạt lỗ với số lần đánh ít nhất. Một vòng golf thường bao gồm 18 lỗ. Mỗi lỗ được chơi một lần trong một vòng trên sân golf tiêu chuẩn. Mỗi cú đánh được tính là một điểm, và tổng số cú đánh được sử dụng để xác định người chiến thắng.

Knowledge 2:

Golf là môn thể thao sử dụng gậy và bóng chính xác, trong đó người chơi (hoặc người chơi golf) sử dụng nhiều loại gậy để đánh bóng vào một loạt các lỗ trên sân với số lần đánh ít nhất. Mục tiêu là hoàn thành sân với số điểm thấp nhất, được tính bằng cách cộng tổng số cú đánh ở mỗi lỗ. Người chơi có số điểm thấp nhất sẽ thắng.

Chúng tôi đang sử dụng gợi ý được cung cấp trong bài báo của Liu và cộng sự năm 2022. Bước tiếp theo là tích hợp kiến thức và đưa ra dự đoán. Tôi đã định dạng lại câu hỏi theo định dạng QA để định hướng cho định dạng câu trả lời.

Prompt:

Câu hỏi: Một phần của golf là cố gắng đạt tổng điểm cao hơn người khác. Có hay không?

Kiến thức: Mục tiêu của golf là chơi một loạt lỗ với số gậy ít nhất. Một vòng golf thường bao gồm 18 lỗ. Mỗi lỗ được chơi một lần trong vòng trên sân golf tiêu chuẩn. Mỗi gậy được tính là một điểm, và tổng số gậy được sử dụng để xác định người chiến thắng.
Giải thích và Trả lời:

Câu trả lời 1 (độ tin cậy rất cao):

Không, mục tiêu của golf không phải là đạt tổng điểm cao hơn người khác. Thay vào đó, mục tiêu là chơi một loạt lỗ với số gậy ít nhất. Tổng số gậy được sử dụng để xác định người chiến thắng, chứ không phải tổng số điểm. 
Câu hỏi: Một phần của golf là cố gắng đạt tổng điểm cao hơn người khác. Có hay không?

Kiến thức: Golf là môn thể thao chính xác sử dụng gậy và bóng, trong đó người chơi (hoặc người chơi golf) sử dụng nhiều loại gậy khác nhau để đánh bóng vào một loạt các lỗ trên sân với số lần đánh ít nhất. Mục tiêu là hoàn thành sân với điểm số thấp nhất, được tính bằng cách cộng tổng số gậy đánh được ở mỗi lỗ. Người chơi có điểm số thấp nhất sẽ thắng.

Giải thích và Trả lời:

Câu trả lời 2 (độ tin cậy thấp hơn nhiều):

Đúng vậy, một phần của golf là cố gắng đạt tổng điểm cao hơn những người khác. Mỗi người chơi đều cố gắng hoàn thành sân với điểm số thấp nhất, được tính bằng cách cộng tổng số gậy đánh được ở mỗi lỗ. Người chơi có điểm số thấp nhất sẽ thắng.

Một số điều thực sự thú vị đã xảy ra với ví dụ này. Trong câu trả lời đầu tiên, mô hình rất tự tin nhưng trong câu trả lời thứ hai thì không. Tôi đã đơn giản hóa quy trình để minh họa, nhưng vẫn còn một vài chi tiết cần xem xét khi đi đến câu trả lời cuối cùng. Xem bài báo để biết thêm.

Về ‘Kỹ thuật viết lời nhắc’ ………. Phần trước ………. Phần tiếp theo

LLMs continue to be improved and one popular technique includes the ability to incorporate knowledge or information to help the model make more accurate predictions.

Using a similar idea, can the model also be used to generate knowledge before making a prediction? That's what is attempted in the paper by Liu et al. 2022 -- generate knowledge to be used as part of the prompt. In particular, how helpful is this for tasks such as commonsense reasoning?

Let's try a simple prompt:

Prompt:

Part of golf is trying to get a higher point total than others. Yes or No?

Output:

Yes.

This type of mistake reveals the limitations of LLMs to perform tasks that require more knowledge about the world. How do we improve this with knowledge generation?

First, we generate a few "knowledges":

Prompt:

Input: Greece is larger than mexico.
Knowledge: Greece is approximately 131,957 sq km, while Mexico is approximately 1,964,375 sq km, making Mexico 1,389% larger than Greece.

Input: Glasses always fog up.
Knowledge: Condensation occurs on eyeglass lenses when water vapor from your sweat, breath, and ambient humidity lands on a cold surface, cools, and then changes into tiny drops of liquid, forming a film that you see as fog. Your lenses will be relatively cool compared to your breath, especially when the outside air is cold.

Input: A fish is capable of thinking.
Knowledge: Fish are more intelligent than they appear. In many areas, such as memory, their cognitive powers match or exceed those of ’higher’ vertebrates including non-human primates. Fish’s long-term memories help them keep track of complex social relationships.

Input: A common effect of smoking lots of cigarettes in one’s lifetime is a higher than normal chance of getting lung cancer.
Knowledge: Those who consistently averaged less than one cigarette per day over their lifetime had nine times the risk of dying from lung cancer than never smokers. Among people who smoked between one and 10 cigarettes per day, the risk of dying from lung cancer was nearly 12 times higher than that of never smokers.

Input: A rock is the same size as a pebble.
Knowledge: A pebble is a clast of rock with a particle size of 4 to 64 millimetres based on the Udden-Wentworth scale of sedimentology. Pebbles are generally considered larger than granules (2 to 4 millimetres diameter) and smaller than cobbles (64 to 256 millimetres diameter).

Input: Part of golf is trying to get a higher point total than others.
Knowledge:

Knowledge 1:

The objective of golf is to play a set of holes in the least number of strokes. A round of golf typically consists of 18 holes. Each hole is played once in the round on a standard golf course. Each stroke is counted as one point, and the total number of strokes is used to determine the winner of the game.

Knowledge 2:

Golf is a precision club-and-ball sport in which competing players (or golfers) use many types of clubs to hit balls into a series of holes on a course using the fewest number of strokes. The goal is to complete the course with the lowest score, which is calculated by adding up the total number of strokes taken on each hole. The player with the lowest score wins the game.

We are using the prompt provided in the paper by Liu et al. 2022.

The next step is to integrate the knowledge and get a prediction. I reformatted the question into QA format to guide the answer format.

Prompt:

Question: Part of golf is trying to get a higher point total than others. Yes or No?

Knowledge: The objective of golf is to play a set of holes in the least number of strokes. A round of golf typically consists of 18 holes. Each hole is played once in the round on a standard golf course. Each stroke is counted as one point, and the total number of strokes is used to determine the winner of the game.

Explain and Answer: 

Answer 1 (confidence very high):

No, the objective of golf is not to get a higher point total than others. Rather, the objective is to play a set of holes in the least number of strokes. The total number of strokes is used to determine the winner of the game, not the total number of points.
Question: Part of golf is trying to get a higher point total than others. Yes or No?

Knowledge: Golf is a precision club-and-ball sport in which competing players (or golfers) use many types of clubs to hit balls into a series of holes on a course using the fewest number of strokes. The goal is to complete the course with the lowest score, which is calculated by adding up the total number of strokes taken on each hole. The player with the lowest score wins the game.

Explain and Answer:

Answer 2 (confidence is a lot lower):

Yes, part of golf is trying to get a higher point total than others. Each player tries to complete the course with the lowest score, which is calculated by adding up the total number of strokes taken on each hole. The player with the lowest score wins the game.

Some really interesting things happened with this example. In the first answer, the model was very confident but in the second not so much. I simplified the process for demonstration purposes but there are a few more details to consider when arriving at the final answer. Check out the paper for more.

Dịch: Lê Trung Nghĩa

letrungnghia.foss@gmail.com

Thứ Hai, 3 tháng 11, 2025

Hướng dẫn kỹ thuật lời nhắc. Kỹ thuật viết lời nhắc. Tự nhất quán


Self-Consistency

Theo: https://www.promptingguide.ai/techniques/consistency

Có lẽ một trong những kỹ thuật tiên tiến hơn hiện có cho kỹ thuật nhắc là tự nhất quán. Được đề xuất bởi Wang và cộng sự (2022), tự nhất quán nhằm mục đích "thay thế cách giải mã tham lam ngây thơ được sử dụng trong lời nhắc theo chuỗi suy nghĩ". Ý tưởng là lấy mẫu nhiều đường suy luận đa dạng thông qua CoT với vài ví dụ/minh họa, và sử dụng các thế hệ để chọn ra câu trả lời nhất quán nhất. Điều này giúp tăng hiệu suất của lời nhắc CoT trong các nhiệm vụ liên quan đến số học và suy luận thông thường.

Hãy thử ví dụ sau về suy luận số học:

Prompt:

Khi tôi 6 tuổi, chị gái tôi chỉ bằng một nửa tuổi tôi. Bây giờ tôi 70 tuổi, chị gái tôi bao nhiêu tuổi?

Output:

35

Đầu ra sai! Làm thế nào chúng ta có thể cải thiện điều này bằng tính nhất quán? Hãy thử xem. Chúng ta sẽ sử dụng các ví dụ với vài ví dụ/minh họa từ Wang và cộng sự, 2022 (Bảng 17):

Prompt:

Hỏi: Có 15 cây trong khu rừng. Hôm nay, các công nhân khu rừng sẽ trồng cây trong khu rừng. Sau khi hoàn thành, sẽ có 21 cây. Vậy hôm nay các công nhân khu rừng đã trồng bao nhiêu cây?
Đáp: Ban đầu chúng ta có 15 cây. Sau đó chúng ta có 21 cây. Khác biệt phải là số cây họ đã trồng. Vậy, họ phải trồng 21 - 15 = 6 cây. Đáp án là 6.

Hỏi: Nếu có 3 ô tô trong bãi đậu xe và có thêm 2 ô tô nữa đến, vậy có bao nhiêu ô tô trong bãi đậu xe?
Đáp: Đã có 3 ô tô trong bãi đậu xe. Thêm 2 ô tô nữa đến. Bây giờ có 3 + 2 = 5 ô tô. Đáp án là 5.

Hỏi: Leah có 32 viên sô cô la và em gái cô ấy có 42 viên. Nếu họ ăn 35 viên, tổng cộng họ còn lại bao nhiêu viên?
Đáp: Leah có 32 viên kẹo sô cô la và em gái Leah có 42 viên. Điều đó có nghĩa là ban đầu có 32 + 42 = 74 viên kẹo sô cô la. Đã ăn hết 35 viên. Vậy tổng cộng họ vẫn còn 74 - 35 = 39 viên kẹo sô cô la. Câu trả lời là 39.

Hỏi: Jason có 20 viên kẹo. Cậu ấy đã cho Denny một ít kẹo. Bây giờ Jason có 12 viên kẹo. Jason đã cho Denny bao nhiêu viên kẹo?
Đáp: Jason có 20 viên kẹo. Vì bây giờ cậu ấy chỉ còn 12 viên, nên cậu ấy hẳn đã cho Denny số kẹo còn lại. Số kẹo cậu ấy đã cho Denny phải là 20 - 12 = 8 viên kẹo. Câu trả lời là 8.

Hỏi: Shawn có 5 món đồ chơi. Vào dịp Giáng sinh, cậu ấy nhận được 2 món đồ chơi từ bố và mẹ. Vậy bây giờ cậu ấy có bao nhiêu món đồ chơi?
Đáp: Cậu ấy có 5 món đồ chơi. Cậu bé được mẹ cho 2 món đồ chơi, vậy là cậu bé có 5 + 2 = 7 đồ chơi. Sau đó, cậu được bố cho thêm 2 món nữa, vậy tổng cộng cậu bé có 7 + 2 = 9 món đồ chơi. Đáp án là 9.

Hỏi: Có 9 máy tính trong phòng máy chủ. Mỗi ngày, từ thứ Hai đến thứ Năm, lại lắp thêm 5 máy tính nữa. Vậy hiện tại có bao nhiêu máy tính trong phòng máy chủ?
Đáp: Có 4 ngày, từ thứ Hai đến thứ Năm. Mỗi ngày lại có thêm 5 máy tính. Điều đó có nghĩa là tổng cộng có 4 * 5 = 20 máy tính được lắp thêm. Ban đầu có 9 máy tính, vậy bây giờ có 9 + 20 = 29 máy tính.
Đáp án là 29.

Hỏi: Michael có 58 quả bóng gôn. Vào thứ Ba, cậu bé làm mất 23 quả bóng gôn. Vào thứ Tư, cậu bé làm mất thêm 2 quả bóng gôn. Vậy cuối ngày thứ Tư, cậu bé có bao nhiêu quả bóng gôn?
Đáp: Ban đầu, Michael có 58 quả bóng gôn. Hôm thứ Ba, anh ấy làm mất 23 quả bóng, vậy sau đó anh ấy còn 58 - 23 = 35 quả bóng. Hôm thứ Tư, anh ấy làm mất thêm 2 quả nữa, vậy bây giờ anh ấy còn 35 - 2 = 33 quả bóng. Câu trả lời là 33. 

Hỏi: Olivia có 23 đô la. Cô ấy mua 5 bánh mì tròn với giá 3 đô la mỗi chiếc. Hỏi cô ấy còn lại bao nhiêu tiền?
Đáp: Cô ấy mua 5 chiếc bánh mì tròn với giá 3 đô la mỗi chiếc. Điều này có nghĩa là cô ấy đã tiêu hết 15 đô la. Vậy cô ấy còn lại 8 đô la.

Hỏi: Khi tôi 6 tuổi, chị gái tôi bằng một nửa tuổi tôi. Bây giờ tôi 70 tuổi, vậy chị gái tôi bao nhiêu tuổi?
A:

Output 1:

Khi tôi 6 tuổi, em gái tôi bằng một nửa tuổi tôi, tức là em ấy 3 tuổi. Bây giờ tôi 70 tuổi, tức là em ấy 70 - 3 = 67. Đáp án là 67.

Output 2:

Khi người kể chuyện 6 tuổi, em gái anh ấy bằng một nửa tuổi anh ấy, tức là 3 tuổi. Bây giờ người kể chuyện 70 tuổi, tức là em gái anh ấy 70 - 3 = 67 tuổi. Đáp án là 67.

Output 3:

Khi tôi 6 tuổi, em gái tôi bằng một nửa tuổi tôi, tức là em ấy 3 tuổi. Bây giờ tôi 70 tuổi, tức là em ấy 70/2 = 35. Đáp án là 35.

Việc tính toán để đưa ra câu trả lời cuối cùng bao gồm một vài bước (xem tài liệu để biết chi tiết) nhưng để đơn giản, chúng ta có thể thấy rằng đã có một câu trả lời đa số xuất hiện nên về cơ bản đó sẽ trở thành câu trả lời cuối cùng.

Về ‘Kỹ thuật viết lời nhắc’ ………. Phần trước ………. Phần tiếp theo

Perhaps one of the more advanced techniques out there for prompt engineering is self-consistency. Proposed by Wang et al. (2022), self-consistency aims "to replace the naive greedy decoding used in chain-of-thought prompting". The idea is to sample multiple, diverse reasoning paths through few-shot CoT, and use the generations to select the most consistent answer. This helps to boost the performance of CoT prompting on tasks involving arithmetic and commonsense reasoning.

Let's try the following example for arithmetic reasoning:

Prompt:

When I was 6 my sister was half my age. Now
I’m 70 how old is my sister?

Output:

35

The output is wrong! How may we improve this with self-consistency? Let's try it out. We will use the few-shot exemplars from Wang et al. 2022 (Table 17):

Prompt:

Q: There are 15 trees in the grove. Grove workers will plant trees in the grove today. After they are done,
there will be 21 trees. How many trees did the grove workers plant today?
A: We start with 15 trees. Later we have 21 trees. The difference must be the number of trees they planted.
So, they must have planted 21 - 15 = 6 trees. The answer is 6.

Q: If there are 3 cars in the parking lot and 2 more cars arrive, how many cars are in the parking lot?
A: There are 3 cars in the parking lot already. 2 more arrive. Now there are 3 + 2 = 5 cars. The answer is 5.

Q: Leah had 32 chocolates and her sister had 42. If they ate 35, how many pieces do they have left in total?
A: Leah had 32 chocolates and Leah’s sister had 42. That means there were originally 32 + 42 = 74
chocolates. 35 have been eaten. So in total they still have 74 - 35 = 39 chocolates. The answer is 39.

Q: Jason had 20 lollipops. He gave Denny some lollipops. Now Jason has 12 lollipops. How many lollipops
did Jason give to Denny?
A: Jason had 20 lollipops. Since he only has 12 now, he must have given the rest to Denny. The number of
lollipops he has given to Denny must have been 20 - 12 = 8 lollipops. The answer is 8.

Q: Shawn has five toys. For Christmas, he got two toys each from his mom and dad. How many toys does
he have now?
A: He has 5 toys. He got 2 from mom, so after that he has 5 + 2 = 7 toys. Then he got 2 more from dad, so
in total he has 7 + 2 = 9 toys. The answer is 9.

Q: There were nine computers in the server room. Five more computers were installed each day, from
monday to thursday. How many computers are now in the server room?
A: There are 4 days from monday to thursday. 5 computers were added each day. That means in total 4 * 5 =
20 computers were added. There were 9 computers in the beginning, so now there are 9 + 20 = 29 computers.
The answer is 29.

Q: Michael had 58 golf balls. On tuesday, he lost 23 golf balls. On wednesday, he lost 2 more. How many
golf balls did he have at the end of wednesday?
A: Michael initially had 58 balls. He lost 23 on Tuesday, so after that he has 58 - 23 = 35 balls. On
Wednesday he lost 2 more so now he has 35 - 2 = 33 balls. The answer is 33.

Q: Olivia has $23. She bought five bagels for $3 each. How much money does she have left?
A: She bought 5 bagels for $3 each. This means she spent $15. She has $8 left.

Q: When I was 6 my sister was half my age. Now I’m 70 how old is my sister?
A:

Output 1:

When I was 6 my sister was half my age, so she was 3. Now I am 70, so she is 70 - 3 = 67. The answer is 67.

Output 2:

When the narrator was 6, his sister was half his age, which is 3. Now that the narrator is 70, his sister would be 70 - 3 = 67 years old. The answer is 67.

Output 3:

When I was 6 my sister was half my age, so she was 3. Now I am 70, so she is 70/2 = 35. The answer is 35.

Computing for the final answer involves a few steps (check out the paper for the details) but for the sake of simplicity, we can see that there is already a majority answer emerging so that would essentially become the final answer.

Dịch: Lê Trung Nghĩa

letrungnghia.foss@gmail.com

Chủ Nhật, 2 tháng 11, 2025

Hướng dẫn kỹ thuật lời nhắc. Kỹ thuật viết lời nhắc. Siêu lời nhắc (Meta Prompting)


Meta Prompting

Theo: https://www.promptingguide.ai/techniques/meta-prompting

Giới thiệu

Siêu lời nhắc (Meta Prompting) là một kỹ thuật nhắc nâng cao, tập trung vào các khía cạnh cấu trúc và cú pháp của các nhiệm vụ và vấn đề hơn là chi tiết nội dung cụ thể của chúng. Mục tiêu của meta prompting là xây dựng một cách tương tác trừu tượng và có cấu trúc hơn với các mô hình ngôn ngữ lớn (LLM), nhấn mạnh hình thức và mô hình/ nguyên mẫu thông tin so với các phương pháp truyền thống tập trung vào nội dung.

Đặc điểm chính

Theo Zhang và cộng sự (2024), các đặc điểm chính của meta prompting có thể được tóm tắt như sau:

  1. Định hướng cấu trúc: Ưu tiên định dạng và mô hình/nguyên mẫu của vấn đề và giải pháp hơn là nội dung cụ thể.

  2. Tập trung vào cú pháp: Sử dụng cú pháp làm khuôn mẫu hướng dẫn cho phản hồi hoặc giải pháp dự kiến.

  3. Ví dụ trừu tượng: Sử dụng các ví dụ trừu tượng làm khuôn khổ, minh họa cấu trúc của vấn đề và giải pháp mà không tập trung vào các chi tiết cụ thể.

  4. Linh hoạt: Áp dụng trên nhiều lĩnh vực khác nhau, có khả năng cung cấp các câu trả lời có cấu trúc cho nhiều loại vấn đề.

  5. Phương pháp tiếp cận theo phạm trù: Dựa trên lý thuyết kiểu/dạng/loại để nhấn mạnh việc phân loại và sắp xếp hợp lý các thành phần trong một lời nhắc.

Ưu điểm so với phương pháp lời nhắc với vài ví dụ/minh họa

Zhang và cộng sự, 2024 báo cáo rằng phương pháp siêu lời nhắc (Meta-Prompting) và lời nhắc với vài ví dụ/minh họa (Few-shot Prompting) khác nhau ở chỗ phương pháp siêu lời nhắc tập trung vào cách tiếp cận hướng cấu trúc hơn, trái ngược với phương pháp hướng nội dung mà phương pháp lời nhắc với vài ví dụ/minh họa nhấn mạnh.

Ví dụ sau đây được lấy từ Zhang và cộng sự (2024) minh họa sự khác biệt giữa một siêu lời nhắc có cấu trúc và một lời nhắc với vài ví dụ/minh họa trong việc giải quyết các bài toán từ chuẩn MATH:


Ưu điểm của siêu lời nhắc so với lời nhắc với vài ví dụ/minh họa bao gồm:

  1. Hiệu quả của mã thông báo (Token): Giảm số lượng mã thông báo cần thiết bằng cách tập trung vào cấu trúc thay vì nội dung chi tiết.

  2. So sánh công bằng: Cung cấp một cách tiếp cận công bằng hơn để so sánh các mô hình giải quyết vấn đề khác nhau bằng cách giảm thiểu ảnh hưởng của các ví dụ cụ thể.

  3. Hiệu quả của việc không có ví dụ/minh họa (Zero-shot efficacy): Có thể được xem như một dạng lời nhắc không có ví dụ/minh họa, trong đó ảnh hưởng của các ví dụ cụ thể được giảm thiểu.

Ứng dụng

Bằng cách tập trung vào các mô hình/nguyên mẫu có cấu trúc của giải quyết vấn đề, Meta Prompting cung cấp một lộ trình rõ ràng để điều hướng các chủ đề phức tạp, nâng cao khả năng suy luận của các LLM trên nhiều lĩnh vực khác nhau.

Điều quan trọng cần lưu ý là phương pháp siêu lời nhắc cũng giả định rằng LLM có kiến thức bẩm sinh về nhiệm vụ hoặc vấn đề cụ thể đang được giải quyết. Vì LLM có thể khái quát hóa thành các nhiệm vụ chưa được biết đến, nên có thể tận dụng phương pháp siêu lời nhắc, nhưng hiệu suất có thể giảm sút với các nhiệm vụ độc đáo và mới lạ hơn, như trường hợp của phương pháp lời nhắc không có ví dụ/minh họa (Zero-shot Prompting).

Các ứng dụng trong đó siêu lời nhắc có thể mang lại lợi ích bao gồm nhưng không giới hạn ở các nhiệm vụ suy luận phức tạp, giải quyết vấn đề toán học, thử thách lập trình, truy vấn lý thuyết.

Về ‘Kỹ thuật viết lời nhắc’ ………. Phần trước ………. Phần tiếp theo

Introduction

Meta Prompting is an advanced prompting technique that focuses on the structural and syntactical aspects of tasks and problems rather than their specific content details. This goal with meta prompting is to construct a more abstract, structured way of interacting with large language models (LLMs), emphasizing the form and pattern of information over traditional content-centric methods.

Key Characteristics

According to Zhang et al. (2024), the key characteristics of meta prompting can be summarized as follows:

1. Structure-oriented: Prioritizes the format and pattern of problems and solutions over specific content.

2. Syntax-focused: Uses syntax as a guiding template for the expected response or solution.

3. Abstract examples: Employs abstracted examples as frameworks, illustrating the structure of problems and solutions without focusing on specific details.

4. Versatile: Applicable across various domains, capable of providing structured responses to a wide range of problems.

5. Categorical approach: Draws from type theory to emphasize the categorization and logical arrangement of components in a prompt.

Advantages over Few-Shot Prompting

Zhang et al., 2024 report that meta prompting and few-shot prompting are different in that it meta prompting focuses on a more structure-oriented approach as opposed to a content-driven approach which few-shot prompting emphasizes.

The following example obtained from Zhang et al. (2024) demonstrates the difference between a structured meta prompt and a few-shot prompt for solving problems from the MATH benchmark:

The advantages of Meta Prompting over few-shot promoting include:

1. Token efficiency: Reduces the number of tokens required by focusing on structure rather than detailed content.

2. Fair comparison: Provides a more fair approach for comparing different problem-solving models by minimizing the influence of specific examples.

3. Zero-shot efficacy: Can be viewed as a form of zero-shot prompting, where the influence of specific examples is minimized.

Applications

By focusing on the structural patterns of problem-solving, Meta Prompting offers a clear roadmap for navigating complex topics, enhancing the reasoning capabilities of LLMs across various domains.

It's important to note that meta prompting also assumes that the LLM has innate knowledge about the specific task or problem being addressed. As LLMs can generalize to a unseen tasks, it is possible that they can be leveraged with meta prompting but performance might deteriorate with more unique and novel tasks as is the case with zero-shot prompting.

Applications where meta prompting can be beneficial include but not limited to complex reasoning tasks, mathematical problem-solving, coding challenges, theoretical queries.

Dịch: Lê Trung Nghĩa

letrungnghia.foss@gmail.com