Là bản dịch sang tiếng Việt tài liệu của Michael Weinberg, do GLAM-E Lab xuất bản tháng 6/2025, giấy phép CC BY 4.0.
“Giới thiệu
Vào cuối năm 2024, bắt đầu xuất hiện những báo cáo lẻ tẻ từ các bộ sưu tập di sản văn hóa trực tuyến riêng lẻ. Các báo cáo này mô tả tình trạng máy chủ và hệ thống lưu trữ bị quá tải – và đôi khi gặp sự cố – do sự tấn công dồn dập của các chương trình tự động (bot). Các bot này được cho là đang thu thập toàn bộ dữ liệu từ các bộ sưu tập để xây dựng tập dữ liệu huấn luyện cho các mô hình trí tuệ nhân tạo (AI). Hoạt động này gây áp lực quá lớn lên các hệ thống vốn được thiết kế để duy trì sự hiện diện trực tuyến của các bộ sưu tập đó.
Mặc dù đáng lo ngại, nhưng chưa thể khẳng định ngay liệu những báo cáo này có phản ánh một xu hướng rộng lớn hơn hay không. Liệu chúng có đại diện cho trải nghiệm của đa số các bộ sưu tập trực tuyến? Chúng chỉ là những trường hợp cá biệt? Hay là những dấu hiệu cảnh báo sớm?
GLAM-E Lab đã công bố báo cáo này nhằm giải đáp các câu hỏi trên và bắt đầu phác họa bức tranh toàn cảnh lớn hơn. Báo cáo tập trung đặc biệt vào các bộ sưu tập đã được số hóa và dữ liệu liên quan đến các tổ chức GLAM – bao gồm Phòng trưng bày (Galleries), Thư viện (Libraries), Cơ quan lưu trữ (Archives) và Bảo tàng (Museums).
Vào tháng 4 năm 2025, GLAM-E Lab đã gửi một bản khảo sát ngắn qua các danh sách thư điện tử (listserv) dành cho những người làm việc trong lĩnh vực di sản và công nghệ tại các tổ chức GLAM, bao gồm cả những người trong và ngoài giới học thuật. Cộng đồng này mang tính quốc tế và bao gồm các cơ sở với quy mô đa dạng, từ các cơ quan lưu trữ quốc gia hàng đầu cho đến các bảo tàng địa phương.
Chúng tôi đã đặt câu hỏi cho các tổ chức sở hữu bộ sưu tập trực tuyến – bất kể các bộ sưu tập đó có được cấp phép mở hay không – về trải nghiệm của họ liên quan đến các bot thu thập dữ liệu để huấn luyện AI. Các câu hỏi tập trung vào tác động kỹ thuật mà các bot gây ra (hoặc không gây ra) đối với cơ sở hạ tầng trực tuyến của họ. Mục tiêu của chúng tôi là tìm hiểu xem liệu những báo cáo ban đầu về sự cố có đại diện cho tình hình chung của cộng đồng GLAM hay không, đồng thời hiểu rõ hơn và chi tiết hơn về các vấn đề kỹ thuật mà các bộ sưu tập mở đang gặp phải do bot, và cuối cùng là bắt đầu định hình các giải pháp khả thi….”
Tự do tải về bản dịch sang tiếng Việt của tài liệu có 51 trang tại địa chỉ:
Creative Commons, một đối tác lâu năm của IFLA, đang dẫn đầu nỗ lực vận động cho một Khuyến nghị của UNESCO về Văn hóa Mở (Open Culture). Điều này sẽ tiếp nối các khuyến nghị hiện tại của UNESCO về Khoa học Mở và Tài nguyên Giáo dục Mở.
Vì mục tiêu của Văn hóa Mở tập trung vào việc làm cho di sản văn hóa dễ tiếp cận hơn vì lợi ích của tất cả mọi người, IFLA đã nhiệt tình ủng hộ nỗ lực này. Chúng tôi đã hợp tác với Creative Commons trong những năm qua để thúc đẩy cuộc thảo luận về Văn hóa Mở và đại diện cho các quan điểm đa dạng từ lĩnh vực thư viện, bao gồm cả tại Hội nghị Thượng đỉnh Toàn cầu của Creative Commons ở Mexico City vào tháng 9/2023.
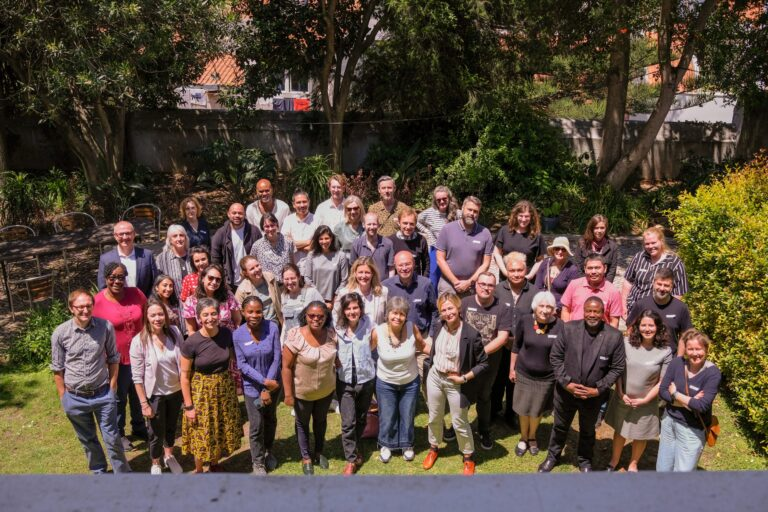
IFLA một lần nữa tham gia cùng Creative Commons trong một hội thảo chuyên sâu tại Lisbon, Bồ Đào Nha được tổ chức vào tháng 5 năm 2024 để giúp vạch ra lộ trình hướng tới một khuyến nghị cuối cùng.
Open Culture Strategic Workshop Group Photo by Filipa Alfama, CC BY 4.0
Văn hóa Mở là gì?
Đã có một cuộc tranh luận sôi nổi về các thông số và định nghĩa của Văn hóa Mở trong bối cảnh dự án này. Theo quan điểm của IFLA, việc tập trung vào số hóa di sản văn hóa và làm cho các bộ sưu tập đó có sẵn cho giáo dục, nghiên cứu và làm giàu văn hóa là trọng tâm thực tế nhất.
Trong đó, IFLA nhấn mạnh sự cần thiết phải đưa ra các ngoại lệ đối với di sản văn hóa có thể không phù hợp với việc tiếp cận mở, chẳng hạn như di sản thuộc về các cộng đồng người bản địa.
Dưới góc độ của Creative Commons, di sản văn hóa được chia sẻ mở sẽ:
dễ dàng được tìm thấy hơn
tiếp cận được nhiều đối tượng khán giả rộng rãi và đa dạng hơn
có thể được bảo tồn, gìn giữ và hoàn thiện dưới dạng kỹ thuật số
có thể được (tái) sử dụng với sự đảm bảo cao hơn về mặt pháp lý
Di sản văn hóa mở dẫn tới:
Đơn vị lưu giữ bộ sưu tập thích ứng tốt hơn và gắn kết hơn với thực tiễn
Hoạt động nghiên cứu sôi nổi hơn và giáo dục mang tính tham gia cao hơn
Sự sáng tạo văn hóa năng động hơn
Các xã hội công bằng, dân chủ, đa dạng, tự do và bình đẳng hơn
Công việc của IFLA hướng tới một văn bản Khuyến nghị
IFLA đã tham gia vào nhóm chuyên gia do Creative Commons quy tụ nhằm thúc đẩy việc xác định các bước tiếp theo trong nỗ lực xây dựng một văn bản khuyến nghị liên chính phủ về Văn hóa Mở.
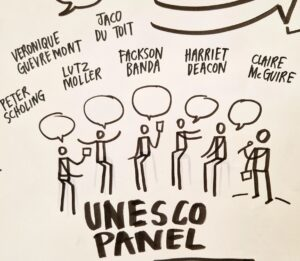
Bà Claire McGuire, Quản lý phụ trách Chính sách và Vận động, đã điều phối một phiên thảo luận với sự tham gia của các đại diện UNESCO ở cấp quốc gia, khu vực và quốc tế. Phiên thảo luận này đã tạo nền tảng thực tiễn cho hội thảo thông qua việc trình bày các quy trình mà UNESCO áp dụng để xây dựng những văn bản mang tính chuẩn mực như vậy.
Điều này có ý nghĩa gì đối với các thư viện?
Trong thời gian tới, IFLA sẽ tiếp tục đóng vai trò chủ chốt cùng với các đối tác từ Creative Commons để triển khai nỗ lực này. Đối với các thư viện, đây là cơ hội để tác động vào một quy trình nhằm thúc đẩy các cam kết quốc gia, từ đó tạo ra môi trường thuận lợi giúp thư viện hoàn thành sứ mệnh của mình.
Khi công việc được triển khai, IFLA sẽ tìm kiếm các cơ hội để đại diện cho quan điểm của ngành thư viện và lan tỏa tiếng nói của các thành viên, hướng tới một kết quả mang lại giá trị cho lĩnh vực thư viện.
Hãy tiếp tục theo dõi để cập nhật thêm thông tin!
IFLA xin gửi lời cảm ơn chân thành đến Creative Commons vì đã mời chúng tôi tham gia hội thảo này!
Creative Commons, a longstanding partner of IFLA, is leading an effort to advocate for a UNESCO Recommendation on Open Culture. This would follow in the footsteps of current UNESCO recommendations on Open Science and Open Educational Resources.
As the goal of Open Culture centres on making cultural heritage more accessible for the benefit of all people, IFLA has been a keen supporter of this effort. We have been collaborating with Creative Commons over the past years to drive forward the discourse on Open Culture and represent diverse perspectives from the library sector, including at the Creative Commons Global Summit in Mexico City in September 2023.
IFLA once again joined Creative Commons for an intensive workshop in Lisbon, Portugal held in May 2024 to help outline a pathway towards an eventual recommendation.
What is Open Culture?
There has been a rich debate on the parameters and definitions of Open Culture in the context of this project. In IFLA’s perspective, a focus on digitising cultural heritage and making those collections available for education, research, and cultural enrichment is the most realistic focus.
In this, IFLA stresses the need to carve out exceptions for cultural heritage that might not be appropriate for open access, such as that belonging to Indigenous communities.
From the perspective of Creative Commons, openly shared cultural heritage:
is easier to find
reaches broader and more diverse audiences
can be preserved, safeguarded and refined in digital form
can be (re)used with more legal certainty
Open cultural heritage leads to:
More resilient and relevant collection holders
More vibrant research and more participatory education
More dynamic cultural creativity
More just, democratic, diverse, free, and equitable societies
IFLA was represented in a group of experts brought together by Creative Commons to further work towards identifying next-steps in the pursuit of an intergovernmental recommendation on Open Culture.
Policy and Advocacy Manager Claire McGuire moderated a panel of UNESCO representatives from the national, regional, and international levels. This grounded the workshop by laying out the processes UNESCO follows to create such normative instruments.
What does this mean for libraries?
Going forward, IFLA will continue to play a central role together with partners from Creative Commons to elaborate this effort. For libraries, this means a chance to influence an process which advances national commitments that create an enabling environment for libraries to succeed in their mission.
As the work develops, IFLA will identify opportunities to represent library perspectives and amplify the voices of our members towards an outcome that will hopefully bring value to the library sector.
Stay tuned for more!
IFLA gives a big thank you to Creative Commons for involving us in this workshop!
Xin chia sẻ với các bạn một bản mẫu (prototype) mới! Mục đích chính của tôi khi xây dựng nó là khơi gợi cảm hứng để các bạn suy nghĩ về việc kết hợp nội dung mở (open content) và AI tạo sinh mở (open generative AI). Sự kết hợp này nhằm tạo ra các tài nguyên học tập tương tác, được cấp phép mở, miễn phí sử dụng và có thể vận hành cục bộ (ngay trên máy tính của bạn) mà không cần kết nối máy chủ bên ngoài.
Mô hình thử nghiệm này kết hợp ba yếu tố: (1) sách giáo khoa OpenStax, (2) sơ đồ tri thức (knowledge graph) biểu diễn nội dung cuốn sách, và (3) mô hình ngôn ngữ lớn trọng số mở (open weights LLM) chạy cục bộ ngay trong trình duyệt web của bạn. Việc LLM chạy cục bộ đồng nghĩa với việc bạn có thể trò chuyện thoải mái mà không tốn phí theo từng token; còn sơ đồ tri thức cho phép bạn duyệt qua bản đồ trực quan của cuốn sách, nơi các phần được liên kết chặt chẽ với chính nội dung tài liệu.
Vì "trăm nghe không bằng một thấy", mời bạn xem video demo ngắn dưới 3 phút này:
Đây thực sự chỉ là một bản mẫu thử nghiệm và có thể gặp lỗi hoặc trục trặc khi bạn sử dụng. Tuy nhiên, bạn có thể trải nghiệm thử tại địa chỉ: genoer.netlify.app.
Nếu bạn cũng đang thử nghiệm các phương pháp kết hợp AI tạo sinh và OER, tôi vừa phát hành một số công cụ với hy vọng sẽ giúp quá trình khám phá của bạn thuận tiện hơn. Càng nhiều người cùng thử nghiệm, chúng ta càng nhanh chóng tìm ra những đổi mới hữu ích!
Các công cụ này hoạt động với sách giáo khoa OpenStax ở định dạng nguồn "Connexions XML" (CNXML) có sẵn trên GitHub. Ví dụ: bạn có thể tìm thấy cuốn Nhập môn Tâm lý học (Introduction to Psychology ) của họ trên GitHub.
Công cụ đầu tiên của tôi, openstax-convert, chuyển đổi kho lưu trữ sách OpenStax thành một tệp book.json duy nhất được phân chia theo khối (kèm theo các hình ảnh thực sự được cuốn sách tham chiếu đến); tệp này sẵn sàng để đưa vào trình đọc, công cụ học tập, quy trình RAG (truy xuất và cung cấp ngữ cảnh) hoặc các công cụ khác.
Công cụ thứ hai, openstax-graph, sử dụng đầu ra từ openstax-convert để tạo ra một đồ thị tri thức có phân loại và đã được kiểm chứng qua quy trình đối kháng (adversarially-verified). Đồ thị này bao gồm các khái niệm, các thực thể thực tế minh họa cho chúng, các phần nội dung chứa chúng, cùng các mối quan hệ giữa chúng (là một loại của, là một phần của, phụ thuộc vào, tương phản với, liên quan đến, minh họa cho), cộng thêm một đồ thị có hướng không chu trình (DAG) thể hiện các điều kiện tiên quyết. Đồ thị được xuất ra dưới dạng một tệp graph.json duy nhất, sẵn sàng để sử dụng trong nhiều ứng dụng khác nhau.
Chúc bạn có trải nghiệm thú vị và đừng quên chia sẻ những gì bạn tạo ra nhé!
New prototype to share! My main purpose in building it is to inspire you to think more about how open content and open generative AI can be combined to create openly licensed, freely available, interactive learning resources that run privately and locally.
This proof-of-concept combines (1) an OpenStax textbook, (2) a knowledge-graph representation of the book’s contents, and (3) an open weights LLM that runs locally inside your web browser. The locally-running LLM means you can chat forever without having to pay per-token costs, and the knowledge graph means you can browse a visual map of the book that is interlinked with the content itself.
Since a demo is worth a 1000 words, here’s a < 3 minute demo:
This is definitely a prototype and may explode when you try to use it. But you can play around with it at genoer.netlify.app.
-----------------------------------------------
If you’re also experimenting with ways to combine generative AI and OER, I’ve just released some tools I hope will make your explorations easier. More people experimenting means we discover useful innovations more quickly!
These tools work with OpenStax textbooks in their source format, “Connexions XML” (CNXML), available in Github. For example, you can find their Introduction to Psychology text in Github.
My first tool, openstax-convert, converts an OpenStax book repo into a single block-segmented book.json file (plus only the images the book actually references), ready to drop into a reader, study tool, retrieval/grounding (RAG) pipeline, or other tool.
The second tool, openstax-graph, takes the output of openstax-convert and derives a typed, adversarially-verified knowledge graph. The graph includes concepts, the real-world entities that illustrate them, the sections where they live, and the relationships between them (is-a, part-of, depends-on, contrasts-with, related-to, illustrates), plus an acyclic prerequisite DAG. The graph is exported as a single graph.json file, ready to use in a wide range of applications.
Các công cụ AI tạo sinh đã đạt đến năng lực vượt xa con người trong việc phát hiện các lỗ hổng bảo mật trong mã nguồn máy tính. Khi mô tả về Claude Mythos Preview, Anthropic gần đây đã viết:
Trong quá trình thử nghiệm, chúng tôi nhận thấy Mythos Preview có khả năng xác định và sau đó khai thác các lỗ hổng zero-day trên mọi hệ điều hành và trình duyệt web phổ biến khi được người dùng yêu cầu. Các lỗ hổng mà nó tìm thấy thường rất tinh vi hoặc khó phát hiện. Nhiều lỗ hổng trong số đó đã tồn tại từ 10 hoặc 20 năm trước; lỗ hổng lâu đời nhất mà chúng tôi tìm thấy cho đến nay là một lỗi đã 27 năm tuổi trong OpenBSD—một hệ điều hành vốn nổi tiếng về tính bảo mật—và lỗi này hiện đã được khắc phục.
Tương tự, Mozilla báo cáo rằng Claude Mythos Preview đã phát hiện 271 lỗ hổng trong Firefox, một phần mềm khác vốn đã hoàn thiện và được kiểm tra cực kỳ kỹ lưỡng. v.v.
Hệ quả của Định luật Linus
Trước đây, hệ quả chính của việc mở mã nguồn của bạn (open sourcing your code) là tạo điều kiện hợp tác với người dùng, giúp phần mềm hữu ích hơn và tăng cường tính bảo mật. Eric Raymond đã gọi những tác động về mặt bảo mật của nguồn mở là Định luật Linus:
Với đủ số lượng người cùng xem xét, mọi lỗi đều trở nên dễ phát hiện.
Một cách hiểu Định luật Linus trong bối cảnh AI tạo sinh là: một mô hình mạnh mẽ như Claude Mythos Preview cung cấp số lượng "cặp mắt" quan sát gần như vô hạn. Có lẽ giờ đây chúng ta cần đến một hệ quả bổ sung cho Định luật Linus:
Với AI đủ mạnh, mọi lỗ hổng đều sẽ bị phát hiện và khai thác.
Tôi chưa nắm được đủ chi tiết về vụ xâm nhập hệ thống Canvas để biết chính xác hệ thống đã bị tấn công như thế nào, nhưng khi nghe tin, suy nghĩ đầu tiên của tôi là: Chắc chắn vụ này xảy ra vì Canvas là mã nguồn mở. Ai đó đã sử dụng AI mạnh mẽ để rà soát mã nguồn, tìm ra các lỗ hổng và khai thác một trong số đó. Sau đó, suy nghĩ thứ hai nảy ra trong đầu tôi là: Liệu vụ xâm nhập Canvas có phải là khởi đầu cho sự kết thúc của mã nguồn mở hay không?
Tính bất đối xứng của AI trong phòng thủ
Mozilla chỉ ra rằng các công cụ AI cũng tiếp sức cho các nhà phát triển, đồng thời cũng mang lại cho những người làm công tác bảo mật "siêu năng lực" khi họ rà soát và bảo vệ mã nguồn của mình. Theo báo cáo, Mozilla đã tận dụng rất hiệu quả công nghệ này cho mục đích đó. Tuy nhiên, không phải dự án mã nguồn mở nào cũng được vận hành bởi một tổ chức lớn như Mozilla.
Phần lớn các dự án nguồn mở là những dự án xuất phát từ niềm đam mê, chỉ có một người đóng góp duy nhất làm việc theo hình thức bán thời gian. Liệu chúng ta có thể kỳ vọng những người làm dự án vì đam mê này phải trả phí để tiếp cận các mô hình AI tiên tiến nhất và liên tục tích hợp chúng vào quy trình phát hành sản phẩm hay không? Nếu họ không thể hoặc vì lý do nào đó không muốn làm vậy, họ nên làm gì? Liệu việc chia sẻ mã nguồn – thứ gần như chắc chắn sẽ bị khai thác lỗ hổng – có phải là một lựa chọn phù hợp?
Giờ thì sao?
Có lẽ trong tương lai sẽ xuất hiện các mô hình AI có trọng số mở (open-weights) đủ mạnh mẽ; chúng có thể được vận hành cục bộ (miễn phí) và tích hợp trực tiếp vào các công cụ cũng như quy trình phát triển trong tương lai. Nhưng từ nay đến lúc đó, chúng ta phải làm gì?
Generative AI tools have become superhuman in their capacity to discover vulnerabilities in computer code. Describing the Claude Mythos Preview, Anthropic recently wrote:
During our testing, we found that Mythos Preview is capable of identifying and then exploiting zero-day vulnerabilities in every major operating system and every major web browser when directed by a user to do so. The vulnerabilities it finds are often subtle or difficult to detect. Many of them are ten or twenty years old, with the oldest we have found so far being a now-patched 27-year-old bug in OpenBSD—an operating system known primarily for its security.
Similarly, Mozilla reports that Claude Mythos Preview identified 271 vulnerabilities in Firefox, which is another mature and very thoroughly reviewed piece of software. &c.
Linus’s Corollary
Once upon a time, the primary consequence of open sourcing your code was enabling collaboration with your users, making the software more helpful for them and improving its security. Eric Raymond called the security implications of open source Linus’s Law:
Given enough eyeballs, all bugs are shallow.
One way of understanding Linus’s Law in the context of generative AI is that a model as powerful as Claude Mythos Preview provides essentially infinite eyes. Perhaps we now need Linus’s Corollary:
Given powerful enough AI, all bugs will be found and exploited.
I haven’t heard enough detail yet about the Canvas breach to know how the system was compromised, but when I heard about it my first thought was: I bet this is because Canvas is open source. Someone used powerful AI to review the source code, found vulnerabilities, and exploited one. Then my second thought was: is the Canvas breach the beginning of the end for open source?
The Asymmetry of AI for Defense
Mozilla points out that AI tools empower developers, too, giving defenders superpowers as they review and secure their own code. And according to the report, Mozilla used it very effectively for this purpose. But not every open source project is run by a major organization like Mozilla.
The majority of open source projects are passion projects with a single, part-time contributor. Do we now expect each of these hobbyists to pay for access to frontier AI models and consistently integrate them into their release process? If they can’t or for any reason don’t want to, what should they do? Is sharing code that is all but guaranteed to be exploited an appropriate choice to make?
What Now?
Perhaps in the future there will be sufficiently powerful open weights AI models, and these can be run locally (for free) and integrated directly into whatever future development tools and workflows look like. But until then, what now?
Tôi là người ủng hộ mạnh mẽ Tài nguyên Giáo dục Mở - OER (Open Educational Resources). Thực tế, tôi chính là người tiên phong ủng hộ OER – từ năm 1998, khi tôi tạo ra giấy phép mở đầu tiên cho các tài liệu giáo dục và bắt đầu vận động mọi người cấp phép mở cho chúng. Việc tạo lập và chia sẻ OER là đòn bẩy mạnh mẽ để gia tăng cơ hội giáo dục. (Hiện nay, AI tạo sinh là một phương thức thậm chí còn mạnh mẽ hơn để đạt được mục tiêu này, nhưng đó là chủ đề cho một bài viết khác.)
Vì là người ủng hộ OER, tôi cảm thấy nản lòng trước những tuyên bố thiếu cơ sở mà mọi người thường đưa ra về OER, đặc biệt là khẳng định rằng "việc áp dụng OER giúp cải thiện kết quả học tập của sinh viên!" Điều đó hoàn toàn không đúng. Việc áp dụng OER KHÔNG đảm bảo mang lại kết quả học tập tốt hơn cho sinh viên. Có những nghiên cứu cho thấy việc áp dụng OER gắn liền với kết quả tốt hơn, có nghiên cứu cho thấy không có sự thay đổi nào, và cũng có nghiên cứu cho thấy việc áp dụng OER thực tế lại gắn liền với sự sụt giảm trong kết quả học tập của sinh viên. Sự khác biệt trong kết quả các nghiên cứu này một phần bắt nguồn từ các vấn đề trong cách thiết kế nghiên cứu.
Nghiên cứu có kiểm soát các yếu tố khác biệt về giảng viên hay không?
Nghiên cứu có kiểm soát các yếu tố khác biệt về sự hỗ trợ dành cho giảng viên hay không?
Nghiên cứu có kiểm soát các yếu tố khác biệt về thiết kế sư phạm của tài liệu học tập hay không?
Khi một nghiên cứu được cho là về OER không giải đáp được các câu hỏi này, thì thực chất nó không trả lời được câu hỏi về hiệu quả của OER. Thay vào đó:
Khi một nghiên cứu không kiểm soát được sự khác biệt về giảng viên, thì điều mà nghiên cứu đó thực sự đo lường là: "Kết quả học tập khác nhau như thế nào giữa sinh viên học với những giảng viên chọn áp dụng các đổi mới như OER và sinh viên học với những giảng viên chọn không áp dụng chúng?"
Khi một nghiên cứu không kiểm soát được sự khác biệt về sự hỗ trợ dành cho giảng viên, thì điều mà nghiên cứu đó thực sự đo lường là: "Sinh viên của những giảng viên được hỗ trợ tốt đạt kết quả ra sao so với sinh viên của những giảng viên không nhận được sự hỗ trợ tương đương?"
Khi một nghiên cứu không kiểm soát được sự khác biệt về thiết kế sư phạm giữa OER và tài liệu có bản quyền truyền thống - TCM (Traditionally Copyrighted Materials), thì thực chất nghiên cứu đó đang đặt câu hỏi: "Sinh viên được giảng dạy theo phương pháp sư phạm X đạt kết quả ra sao so với sinh viên được giảng dạy theo phương pháp sư phạm Y?"
Ngay từ đầu, tiêu đề báo cáo đã khiến tôi hơi băn khoăn, bởi AAC&U định nghĩa "các thực tiễn có tác động cao" là những phương pháp "đã được khẳng định rõ ràng trong các tài liệu nghiên cứu là đòn bẩy mạnh mẽ cho sự thành công của sinh viên trong giáo dục đại học". Tuy nhiên, báo cáo thực sự chứa đựng nhiều khía cạnh tinh tế và chi tiết đáng giá mà tôi rất trân trọng.
Tôi không rõ liệu các tác giả có đọc tài liệu giới thiệu cơ bản (primer) của tôi hay không, nhưng họ đã đề cập cụ thể đến cả ba vấn đề chính được nêu trong tài liệu đó (điều mà các nghiên cứu trước đây về OER hiếm khi – hoặc chưa từng – thực hiện):
Các tác giả kiểm soát sự khác biệt giữa các giảng viên bằng cách so sánh kết quả học tập của sinh viên trước khi giảng viên áp dụng OER với kết quả của chính những sinh viên đó sau khi giảng viên áp dụng OER. Đây thực sự là một điểm tuyệt vời và tôi rất phấn khích khi thấy điều này.
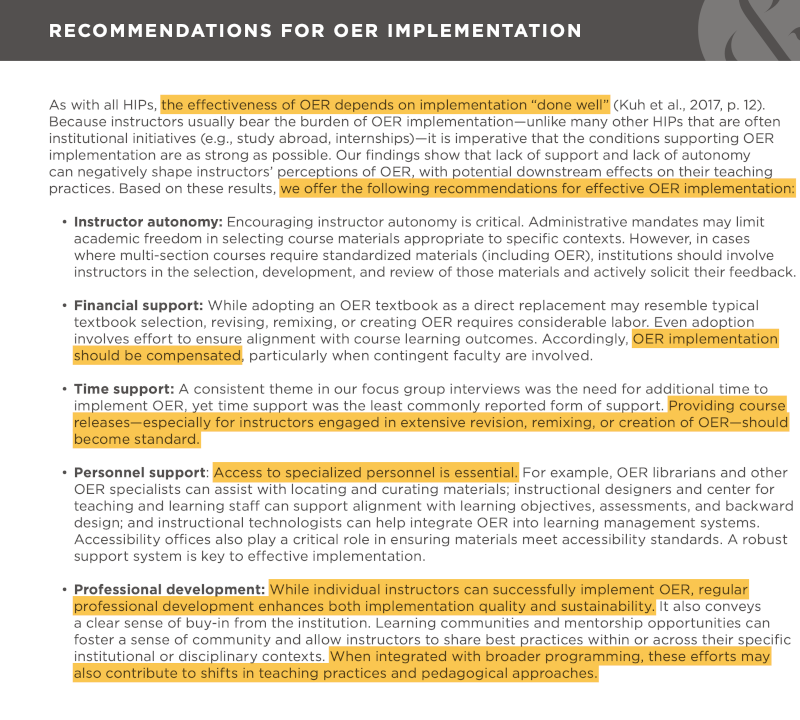
Các tác giả đi sâu tìm hiểu các hình thức hỗ trợ mà giảng viên nhận được, bao gồm hỗ trợ tài chính, giảm tải giờ dạy (release time), hỗ trợ từ các chuyên gia như thủ thư và chuyên gia thiết kế giảng dạy, cũng như các hoạt động phát triển chuyên môn.
Các tác giả cũng nắm bắt những khác biệt ở mức độ tổng quát trong thiết kế giảng dạy dựa trên khái niệm của Hofer về mức độ triển khai OER "cao" và "thấp" – trong nghiên cứu này, khái niệm đó được cụ thể hóa thành việc giảng viên sử dụng nguyên trạng sách giáo khoa OER (mức thấp) hay chỉnh sửa, phối hợp lại (remix) hoặc tự tạo mới tài liệu OER (mức cao).
Mặc dù các tác giả đã thu thập thông tin về sự hỗ trợ dành cho giảng viên và thiết kế giảng dạy, tôi phải thừa nhận mình hơi thất vọng khi họ không sử dụng yếu tố hỗ trợ giảng viên làm biến đồng biến (covariate) trong bất kỳ phân tích nào về kết quả học tập của sinh viên, và chỉ sử dụng mức độ triển khai cao/thấp làm biến đồng biến trong duy nhất một phân tích – đó là mô hình về tỷ lệ bỏ học (withdrawal-rate model). Các phân tích về điểm số và thời gian hoàn thành khóa học chỉ sử dụng các biến dự báo là: có/không sử dụng OER, loại hình cơ sở đào tạo và mức độ phức tạp của người học như các chỉ số dự báo. Điều này khiến chúng ta không thể có được đánh giá định lượng rõ ràng về mức độ đóng góp của sự khác biệt trong hỗ trợ giảng viên hoặc thiết kế giảng dạy đối với sự cải thiện kết quả học tập của sinh viên, so với sự khác biệt về tài liệu giảng dạy (OER hay TCM).
Tuy nhiên, như sẽ thấy ở phần dưới, các tác giả thực sự công nhận vai trò then chốt của sự hỗ trợ từ giảng viên và phương pháp sư phạm đối với thành công của sinh viên! Đây là một điểm tích cực của báo cáo, đồng thời là một khía cạnh hiếm thấy trong các tài liệu nghiên cứu về hiệu quả của OER.
Hoan hô sự tinh tế trong cách nhìn nhận vấn đề!
Báo cáo này chứa đựng những điểm tinh tế rất đáng chú ý, đòi hỏi chúng ta phải quan sát kỹ lưỡng để không bỏ sót chúng!
Báo cáo chủ yếu sử dụng thuật ngữ "triển khai OER" thay vì "áp dụng OER". Đây là một sự phân biệt cực kỳ quan trọng mà độc giả rất dễ bỏ qua.
Ở trang áp chót, báo cáo tóm tắt các kết quả nghiên cứu bằng cách giải thích rằng OER chỉ thực sự là một giải pháp mang lại tác động lớn khi quá trình triển khai được thực hiện "một cách hiệu quả".
Nói cách khác, bạn không thể chỉ trao đổi Tài liệu có bản quyền truyền thống (TCM) lấy Tài nguyên giáo dục mở (OER) và mong đợi thấy những thay đổi có ý nghĩa trong kết quả. Việc áp dụng OER chỉ là một phần của sự can thiệp rộng hơn cần bao gồm cả sự hỗ trợ của người hướng dẫn và những thay đổi trong phương pháp sư phạm nếu bạn muốn cải thiện thành công của sinh viên một cách đáng tin cậy.
(Nếu bạn muốn nói về các tác động của việc chỉ áp dụng OER mà không có các thành phần khác của triển khai có tác động cao, thì sự thật là việc áp dụng OER sẽ tiết kiệm tiền cho sinh viên của bạn và mang lại cho họ những kết quả gần như giống nhau. Và nhận được cùng kết quả với ít tiền hơn là một thỏa thuận tuyệt vời! Nhưng nếu bạn đang tìm kiếm thứ gì đó 'được thiết lập tốt trong tài liệu nghiên cứu như một đòn bẩy mạnh mẽ cho sự thành công của sinh viên trong giáo dục đại học', bạn cần triển khai toàn bộ, "hoàn thành tốt".)
Chỗ duy nhất mà báo cáo chú ý đến sắc thái dường như bị mất đi là ở phần mô tả tác động của OER đối với các điểm số cuối cùng. Báo cáo nêu rằng các điểm A đã tăng lên trong mọi bối cảnh - gần 5 điểm phần trăm tổng thể - và sau đó các thuộc tính thay đổi thành OER. Nhưng việc phân tích điểm số không bao gồm tác động của sự hỗ trợ từ giảng viên hoặc mức độ triển khai. Do đó, sự tăng điểm A đó không thể được quy một cách tự tin cho OER - sự thay đổi về điểm số có thể là do OER, hoặc nó có thể là do sự hỗ trợ mà các giảng viên đã nhận được, hoặc nó có thể là do những thay đổi mà các giảng viên đã thực hiện đối với phương pháp sư phạm của họ, hoặc sự kết hợp nào đó của cả ba. Báo cáo có thể tự tin nói rằng điểm số đã tăng lên, nhưng không thể nói một cách tự tin tại sao chúng lại đã cải thiện. Mâu thuẫn gai góc này cũng chính là điều mà các tác giả đã thừa nhận trong tác phẩm trước đây của họ (Colvard và cộng sự, 2018), và tôi cũng đã thừa nhận trong một số tác phẩm trước đây của mình.
Suy nghĩ cuối cùng
Đây là một báo cáo xuất sắc sẽ đóng góp lớn cho tài liệu nghiên cứu OER. Tôi chỉ hy vọng rằng những người ủng hộ chia sẻ những gì nó thực sự nói: rằng nếu bạn muốn vượt ra ngoài việc tiết kiệm tiền và thực sự cải thiện sự thành công của sinh viên, bạn phải triển khai OER một cách hiệu quả - nghĩa là bạn áp dụng OER và được hỗ trợ tốt về kinh phí, thời gian, khả năng tiếp cận các chuyên gia và phát triển chuyên môn (PD), và sự hỗ trợ đó dẫn bạn áp dụng các thực hành giảng dạy hiệu quả hơn. Đó là khi sự thành công của học sinh được cải thiện một cách có ý nghĩa.
Đừng vung vẩy báo cáo này và nói "Thấy chưa?!? Việc áp dụng OER cải thiện các kết quả!" Hãy nói, “Khi được kết hợp với những hỗ trợ có ý nghĩa của giảng viên và những thay đổi trong thiết kế giảng dạy, việc áp dụng OER góp phần cải thiện kết quả!”
I’m a huge proponent of OER. In fact, I’m the original OER advocate - since 1998, when I created the first open license for educational materials and began working to persuade people to openly license them. Creating and sharing OER is a powerful lever for increasing educational opportunity. (Generative AI is now an even more powerful way of accomplishing this goal, but that’s a subject for another post.)
Because I’m an OER advocate, I’m frustrated by the unfounded claims I hear people make about OER, especially the claim that ‘adopting OER improves student outcomes!’ That’s simply not true. Adopting OER does NOT reliably improve student success. In some studies adopting OER is associated with better outcomes, in some studies there’s no change at all, and it some studies adopting OER is actually associated with decreases in student success. This variability in study results is partly due to problems with the ways studies are designed.
Did the study control for differences in instructors?
Did the study control for differences in instructor support?
Did the study control for differences in the instructional design of the learning materials?
When research that purports to be about OER doesn’t answer these questions, it doesn’t actually answer questions about the effectiveness of OER. Instead:
When a study fails to control for differences in instructors, what that study is really measuring is, “How do outcomes differ when students take courses from the kind of instructors who choose to adopt innovations like OER compared to the students who take classes from the kind of instructors who choose not to?”
When a study fails to control for differences in instructor support, what that study is really measuring is, “How do the students of well-supported instructors perform compared to the students of instructors who are not as well supported?”
When a study fails to control for differences in instructional design between the OER and the TCM, the study is really asking, “How do students taught using pedagogical approach X perform compared to students taught using pedagogical approach Y?”
A New Report from AAC&U
I was excited yesterday to see that the American Association of Colleges and Universities (AAC&U) had released a new research report titled “Open Educational Resources: A New High-Impact Practice.” This is a very large-scale research report whose lead author, Eddie Watson, is a terrific scholar (I’m sure the other authors are as well; Eddie is the only one I know).
The title caused me some concern right off the bat, as AAC&U defines high impact practices as “well established in the research literature as powerful levers for student success in higher education.” But there’s actually plenty of nuance in the report, which I really appreciated.
I don’t know if the authors of the report had read my primer, but they did specifically call out each of the primer’s three issues (which previous OER research rarely - if ever - did):
The authors control for instructor differences by comparing the success of instructors’ students before they adopted OER with the success of those same instructors’ students after they adopted OER. This is genuinely awesome and I was excited to see this.
The authors dig into the kinds of supports instructors receive, including financial support, release time support, support from specialized personnel like librarians and instructional designers, and professional development.
The authors also capture coarse-grained differences in instructional design using Hofer’s notion of “high” and “low” OER implemention - operationalized in this study as whether the instructor adopted an OER textbook as-is (low) or revised, remixed, or created OER materials (high).
While the authors did collect information about instructor support and instructional design, I will admit to being a little disappointed that they never used instructor support as a covariate in any of the student-outcome analyses, and used high/low implementation as a covariate in only a single analysis - the withdrawal-rate model. The grade and time-to-completion analyses use only OER yes/no, institution type, and learner complexity as predictors. That prevents us from getting a clean quantitative read on the degree to which improvements in student success are due to differences in instructor support or instructional design, as opposed to differences in instructional materials (OER or TCM).
But, as we’ll see below, the authors do explicitly recognize the critical role instructor support and pedagogy play in student success! This is a positive for the report, and another rarity in the OER efficacy literature.
Hooray for Nuance!
There is some great nuance in this paper, which means we have to pay close attention so we don’t miss it!
The report predominantly uses the language of “OER implementation” as opposed to “OER adoption.” This is a critically important distinction that will be easy for readers to miss.
On the second-to-last page, the report summarizes its findings by explaining that OER is only a high-impact practice when its implementation is “done well.”
In other words, you can’t just swap Traditionally Copyrighted Materials (TCM) for Open Educational Resources (OER) and expect to see meaningful changes in outcomes. OER adoption is only one part of a broader intervention that needs to include both instructor support and changes in pedagogy if you want to reliably improve student success.
(If you want to talk about the impacts of just adopting OER without the other components of a high impact implementation, the truth is that adopting OER will save your students money and get them roughly the same outcomes. And getting the same outcomes for less money is a great deal! But if you’re looking for something ‘well established in the research literature as a powerful lever for student success in higher education,’ you need the entire, “well done” implementation.)
The one place the report’s attention to nuance seems to lapse is in the description of OER’s impact on final grades. The report states that A grades rose in every context - nearly five percentage points overall - and then attributes that change to OER. But the grade analysis does not include the effects of instructor support or implementation level. Consequently, that bump in A grades can’t be attributed confidently to OER - the change in grades could have been due to OER, or it could have been due to the support instructors received, or it could have been due to changes instructors made to their pedagogy, or some combination of the three. The report can say with confidence that grades rose, but it can’t confidently say why they improved. This thorny tangle of effects is the same confound the authors acknowledge in their earlier work (Colvard et al., 2018), and which I have acknowledged in some of my earlier work as well.
Final Thoughts
This is an excellent report that will make a great contribution to the OER research literature. I just hope that advocates share what it actually says: that if you want to go beyond saving money and actually improve student success, you have to implement OER effectively - meaning you adopt OER, and are well supported with funding, time, access to specialists, and PD, and that the support leads you to adopt more effective teaching practices. That’s when student success improves meaningfully.
Let’s not wave this report around and say “See?!? Adopting OER improves outcomes!” Let’s say, “When combined with meaningful instructor supports and changes in instructional design, OER adoption contributes to improved outcomes!”
Khi tôi (đọc lại) nghiên cứu áp dụng OER qua lăng kính quan trọng hơn, tôi đang thấy một mô hình lặp đi lặp lại của các mối đe dọa đáng kể đối với tính hợp lệ trong các thiết kế của các nghiên cứu nhằm đo lường tác động của việc áp dụng OER lên kết quả đầu ra của sinh viên. Mặc dù có nhiều vấn đề về phương pháp luận cần xem xét nhưng trong bài viết này tôi sẽ thảo luận về ba vấn đề. Cụ thể tôi sẽ chia sẻ:
ba câu hỏi bạn nên hỏi khi đọc nghiên cứu về tác động của việc áp dụng OER tới kết quả đầu ra của sinh viên,
lý do tại sao bạn nên quan tâm đến câu trả lời cho những câu hỏi đó và
những câu hỏi mà nghiên cứu thực sự đang giải quyết khi câu trả lời cho bất kỳ câu hỏi nào trong ba câu hỏi trên là “không”.
Ba câu hỏi cần đặt ra khi bạn đọc nghiên cứu về tác động của việc áp dụng OER
Hãy tự hỏi mình ba câu hỏi này khi bạn đọc nghiên cứu áp dụng OER - đặc biệt là nghiên cứu tuyên bố tìm ra tác động tích cực tới kết quả của sinh viên.
Nghiên cứu có kiểm soát được sự khác biệt về giảng viên không?
Nghiên cứu có kiểm soát được sự khác biệt trong hỗ trợ của giảng viên không?
Nghiên cứu có kiểm soát được những khác biệt trong thiết kế giảng dạy của tài liệu học tập không?
Tại sao bạn nên quan tâm đến câu trả lời cho những câu hỏi này? Bởi vì khi câu trả lời cho bất kỳ câu hỏi nào trong số đó là “không”, nghiên cứu bạn đang đọc không thực sự cho bạn biết bất kỳ điều gì về tác động của OER đối với kết quả của sinh viên - nó cho bạn biết điều gì đó hoàn toàn khác.
Tại sao bạn nên quan tâm đến câu trả lời cho ba câu hỏi
Kiểm soát sự khác biệt về giảng viên
Một số giảng viên có năng lực giảng dạy tốt hơn (hiệu quả hơn) những người khác. Điều này có thể xuất phát từ việc họ áp dụng nhiều phương pháp giảng dạy dựa trên bằng chứng thực tiễn hơn. Cũng có thể do họ thể hiện sự quan tâm, hỗ trợ và niềm tin lớn hơn vào khả năng thành công của sinh viên; hoặc do họ thấu hiểu và linh hoạt hơn trước những biến cố trong cuộc sống của sinh viên. Ngoài ra, còn có những khác biệt quan trọng khác—dù không trực tiếp khiến một người trở thành giảng viên giỏi hơn—nhưng lại có thể đe dọa tính xác thực của các nghiên cứu nếu không được tính đến. Ví dụ, một số giảng viên có xu hướng chấm điểm "dễ" hơn những người khác, v.v.
Nhiều nghiên cứu thường bỏ qua cách thức các giảng viên sử dụng tài nguyên giáo dục mở (OER). Mặc dù đôi khi có những lý do khác (ví dụ: giảng viên thỉnh giảng bắt buộc phải sử dụng OER theo quy định của khóa học), nhưng tình huống phổ biến nhất là giảng viên tự quyết định chọn tài liệu học tập dựa trên quyền tự chủ học thuật của mình. Khi giảng viên không được phân bổ ngẫu nhiên vào nhóm thực nghiệm và nhóm đối chứng, hoặc ít nhất là không thực hiện các biện pháp tương đương hóa (như phương pháp ghép cặp theo điểm xu hướng - propensity score matching), thì gần như không thể tách biệt ảnh hưởng của giảng viên đối với kết quả học tập của sinh viên khỏi ảnh hưởng của OER hoặc các tài liệu có bản quyền truyền thống - TCM (Traditionally Copyrighted Materials).
Việc kiểm soát các yếu tố khác biệt giữa các giảng viên là vô cùng quan trọng, bởi tác động của giảng viên đối với việc học tập của sinh viên có thể lớn hơn nhiều so với tác động của cuốn giáo trình mà họ lựa chọn. Nếu các nhà nghiên cứu không kiểm soát những yếu tố này, những khác biệt về kết quả học tập do ảnh hưởng của giảng viên có thể lấn át sự khác biệt do tính chất "mở" của tài liệu học tập mang lại.
Kiểm soát sự khác biệt về mức độ hỗ trợ dành cho giảng viên
Các nghiên cứu về OER thường được thực hiện song song với các sáng kiến triển khai OER ở cấp độ bộ môn, khoa, trường, hệ thống hoặc toàn tiểu bang. Những giảng viên tham gia các sáng kiến này thường nhận được các quyền lợi như: đào tạo phát triển chuyên môn, sự hỗ trợ từ thủ thư và chuyên gia thiết kế bài giảng, giảm tải giờ dạy và/hoặc nhận thù lao. Ngược lại, những giảng viên không tham gia sáng kiến OER sẽ không nhận được các hình thức hỗ trợ này.
Sẽ chẳng có gì đáng ngạc nhiên khi các giảng viên nhận được sự hỗ trợ bổ sung lại giảng dạy hiệu quả hơn những người không nhận được sự hỗ trợ đó. Hệ quả là, khi một nghiên cứu về sáng kiến OER không mô tả các hình thức hỗ trợ và đãi ngộ mà sáng kiến đó dành cho giảng viên sử dụng OER, chúng ta không thể xác định liệu những khác biệt quan sát được là do bản thân OER hay do sự hỗ trợ bổ sung mà giảng viên nhận được. Nếu các nhà nghiên cứu không kiểm soát các yếu tố này, những khác biệt về kết quả học tập của sinh viên bắt nguồn từ sự hỗ trợ bổ sung cho giảng viên có thể làm lu mờ những khác biệt do tính chất "mở" của tài liệu học tập mang lại.
Kiểm soát sự khác biệt trong thiết kế giảng dạy
Một số tài liệu học tập được thiết kế theo cách hỗ trợ việc học của sinh viên hiệu quả hơn so với những tài liệu khác. Nhiều tài liệu học tập được tạo ra bởi các nhóm chuyên gia có kiến thức chuyên sâu về bộ môn, phương pháp sư phạm, thiết kế giảng dạy, khoa học về sự học, v.v. Trong khi đó, nhiều tài liệu OER lại do một giảng viên duy nhất biên soạn—người có bằng cấp chuyên môn cao nhưng lại thiếu sự đào tạo bài bản về thiết kế giảng dạy hiệu quả.
Hầu hết các nghiên cứu về tác động của OER gần như không cung cấp thông tin gì về chính tài liệu OER hay tài liệu thương mại truyền thống (TCM) được nhóm đối chứng sử dụng, ngoại trừ những gì có thể suy luận từ hình thức cấp phép của chúng. Sẽ ra sao nếu một nhóm sinh viên sử dụng sách giáo khoa in truyền thống, trong khi nhóm khác sử dụng nền tảng tương tác cung cấp bài tập không giới hạn kèm theo phản hồi chuẩn đoán tức thì? Sẽ ra sao nếu một giảng viên chọn tài liệu đi kèm với các slide PowerPoint để thuyết giảng, còn giảng viên khác lại chọn tài liệu có các hướng dẫn cụ thể để triển khai phương pháp học tập chủ động ngay trong giờ học?
Hay nói cách khác, hãy tưởng tượng một thử nghiệm lâm sàng mà báo cáo nghiên cứu chỉ mô tả nhóm thử nghiệm dùng một loại thuốc và nhóm đối chứng dùng một loại thuốc khác, nhưng lại hoàn toàn không đề cập đến thành phần hoạt chất trong cả hai loại thuốc đó! Tình trạng tương tự cũng xảy ra khi không có mô tả nào về thiết kế giảng dạy của tài liệu OER hoặc TCM.
Những khác biệt trong thiết kế giảng dạy sẽ tạo ra tác động lớn hơn đến kết quả học tập của sinh viên so với yếu tố cấp phép "mở" hay "độc quyền" của tài liệu học tập. Nếu các nhà nghiên cứu không kiểm soát các yếu tố này, những khác biệt về kết quả học tập bắt nguồn từ thiết kế sư phạm có thể làm lu mờ những khác biệt do tính chất "mở" của tài liệu học tập mang lại.
Vậy, phần lớn các nghiên cứu về tác động của việc áp dụng OER thực sự giải đáp được những câu hỏi nào?
Khi một nghiên cứu không kiểm soát được sự khác biệt giữa các giảng viên, thì điều mà nghiên cứu đó thực sự đo lường là: "Kết quả học tập khác nhau như thế nào giữa sinh viên học với những giảng viên chọn áp dụng các đổi mới như OER và sinh viên học với những giảng viên chọn không áp dụng các đổi mới đó?"
Khi một nghiên cứu không kiểm soát được sự khác biệt về hỗ trợ dành cho giảng viên, điều mà nghiên cứu đó thực sự đang đo lường là: “Sinh viên của những giảng viên được hỗ trợ tốt có kết quả học tập như thế nào so với sinh viên của những giảng viên không được hỗ trợ tốt?”
Khi một nghiên cứu không kiểm soát được sự khác biệt về thiết kế giảng dạy giữa OER và TCM, nghiên cứu đó thực sự đang hỏi: “Sinh viên được giảng dạy bằng phương pháp sư phạm X có kết quả học tập như thế nào so với sinh viên được giảng dạy bằng phương pháp sư phạm Y?”
As I’ve been (re-)reading OER adoption research through a more critical lens I’m seeing a recurring pattern of significant threats to validity in the designs of studies purporting to measure the impact of OER adoption on student outcomes. While there are numerous methodological issues to consider, in this essay I’ll discuss three. Specifically, I’ll share:
three questions you should ask when you read research about the impact of OER adoption on student outcomes,
the reasons why you should care about the answers to those questions, and
the questions the study is really addressing when the answer to any of the three questions is “no.”
Three questions to ask when you read research on the impact of OER adoption
Ask yourself these three questions when you read OER adoption research - especially research that claims to find a positive impact on student outcomes.
Did the study control for differences in instructors?
Did the study control for differences in instructor support?
Did the study control for differences in the instructional design of the learning materials?
Why should you care about the answers to these questions? Because when the answer to any of them is “no,” the research you’re reading doesn’t actually tell you anything about the impact of OER on student outcomes - it tells you something completely different.
Why you should care about the answers to the three questions
Controlling for differences in instructors
Some instructors are better teachers (more effective teachers) than others. This might be because they employ more evidence-based teaching practices than other instructors. It might be because they demonstrate more care, support, and belief in their students’ ability to succeed. It might be because they’re more understanding and flexible when life happens to their students. And there are other important differences that, while they don’t make someone a better instructor, can threaten the validity of studies if differences in instructors aren’t accounted for. For example, some are “easier graders” than others. &c.
Many research studies fail to address the way instructors end up using OER. While there is occasionally another explanation (e.g., adjuncts teaching a course being required to use OER), the most common scenario is that each instructor is exercising their academic freedom to choose their own course materials. When instructors aren’t randomly assigned to treatment and control, or at a minimum when some kind of matching isn’t done (like propensity score matching), it is literally impossible to separate the influence of the instructor on student learning from the influence of the OER or TCM (traditionally copyrighted materials).
It’s critical to control for differences in instructors because the effect of the instructor on student learning can be significantly larger than the effect of the textbook they choose. If the researchers didn’t control for them, differences in student learning attributable to the impact of the instructors can drown out differences attributable to the impact of the course materials being open.
Controlling for differences in instructor support
OER research is often conducted in conjunction with department, college, institution, system-wide, or statewide OER initiatives. Instructors who participate in these initiatives often receive professional development, support from a librarian, support from an instructional designer, a course release, and / or a stipend. Instructors who don’t participate in the OER initiative don’t receive this support.
It shouldn’t surprise anyone when instructors who receive additional support teach more effectively than instructors who don’t receive that support. Consequently, when a research study describing research associated with an OER initiative fails to describe the support and incentives the initiative provided to faculty who used OER, we can’t tell whether any observed differences are attributable to the OER or to the additional support the instructor received. If the researchers didn’t control for them, differences in student learning attributable to the impact of the additional instructor support can drown out differences attributable to the impact of the course materials being open.
Controlling for differences in instructional design
Some learning materials are designed in ways that support student learning more effectively than others. Many learning materials are created by teams of people with deep expertise in the discipline, pedagogy, instructional design, the learning sciences, &c. Many OER are created by a single instructor with a graduate degree in their discipline and no training whatsoever in the design of effective instruction.
Most research studies on the effects of OER tell us literally nothing about the OER or the TCM used by the control group beyond what can be inferred about their licensing. What if one group of students is using a printed textbook while another is using an interactive platform that provides unlimited practice with immediate, diagnostic feedback? What if one instructor has chosen materials that come with powerpoint slides for use in lecturing, and another instructor has chosen materials that come with explicit supports for doing active learning during class time?
Or, to say it differently, imagine a drug trial where the research report describes a treatment group whose members took a pill, and a control group whose members took a different pill, but there’s no description of the active ingredients in either pill! That’s essentially what’s happening when there’s no description of the instructional design of the OER or the TCM.
Instructional design differences will drive larger changes in student outcomes than the open or proprietary licensing of course materials. If the researchers didn’t control for them, differences in student learning attributable to the impact of the pedagogical design can drown out differences attributable to the impact of the course materials being open.
So what questions does most of the research on the impact of OER adoption actually answer?
When a study fails to control for differences in instructors, what that study is really measuring is, “How do outcomes differ when students take courses from the kind of instructors who choose to adopt innovations like OER compared to the students who take classes from the kind of instructors who choose not to?”
When a study fails to control for differences in instructor support, what that study is really measuring is, “How do the students of well-supported instructors perform compared to the students of instructors who are not as well supported?”
When a study fails to control for differences in instructional design between the OER and the TCM, the study is really asking, “How do students taught using pedagogical approach X perform compared to students taught using pedagogical approach Y?”
Nhân
dịp Đại hội đồng Liên Hợp Quốc (UNGA) họp khóa thứ 81 tại New York vào
tháng 9, Creative Commons (CC) sẽ quy tụ các tổ chức xã hội dân sự và
các tổ chức bảo vệ quyền kỹ thuật số hàng đầu để cùng tham gia "Cuộc đối
thoại về Hợp tác" (A Conversation on Collaboration). Đây là hội nghị chuyên đề kéo dài một ngày nhằm xem xét cách cân bằng giữa chủ quyền kỹ thuật số và sự hợp tác mở.
Cùng
với các đơn vị đồng tổ chức là Public Knowledge, Ushahidi, Project
Liberty Institute, Engelberg Center, Global Solutions Initiative và AI
Disclosures Project, CC sẽ đóng góp vào các cuộc thảo luận mà chính phủ
các nước, Liên minh Châu Âu và Liên Hợp Quốc đang thực hiện trong năm
nay.
Nguồn
mở và chủ quyền kỹ thuật số có mối liên hệ chặt chẽ. Mặc dù nguồn mở
chưa đủ để tạo nên chủ quyền kỹ thuật số, nhưng nó là một nền tảng xây
dựng thiết yếu. Dù định nghĩa về chủ
quyền kỹ thuật số có thể khác nhau, nhưng nhìn chung, chủ quyền kỹ
thuật số ở cấp độ quốc gia được hiểu là khả năng tự chủ kiểm soát mọi
yếu tố, từ cơ sở hạ tầng, phần cứng, phần mềm cho đến dữ liệu.
Các cuộc thảo luận trong ngày sẽ tập trung giải quyết những vấn đề sau:
Các thực hành mở bổ trợ cho nhau ở đâu và nảy sinh xung đột ở đâu?
Tình hình này thay đổi như thế nào ở các cấp độ khác nhau của hệ sinh thái mở—từ cơ sở hạ tầng, phần mềm đến dữ liệu?
Chúng ta có thể học hỏi được gì từ các quan niệm về chủ quyền ở cấp độ cá nhân và cộng đồng?
Vai trò của sự hợp tác giữa các cường quốc tầm trung (Middle Power Collaboration) trong vấn đề này là gì?
Các phiên thảo luận sẽ đi sâu vào toàn bộ các vấn đề nêu trên, đồng thời mang đến cho người tham dự những ví dụ về hợp tác mở.
Thông tin tổ chức
Địa điểm: NYU Engelberg Center, Hội trường Lipton tại Tòa nhà D’Agostino, 108 West 3rd Street, New York.
Thời gian: Thứ Hai, ngày 21 tháng 9 năm 2026.
Khung giờ: 10:00 sáng – 3:00 chiều (mở cửa đón khách lúc 9:30 sáng; có phục vụ bữa trưa).
Đăng ký
Đăng ký tại đây.
Số lượng chỗ có hạn. Giá vé: 10 USD cho sinh viên và 25 USD cho người tham dự thông thường.
As
the United Nations General Assembly (UNGA) convenes its 81st session in
New York in September, Creative Commons is bringing together leading
civil society and digital rights organizations for “A Conversation on
Collaboration,” a day-long symposium examining how to balance digital
sovereignty with open collaboration.
Alongside
co-organizers Public Knowledge, Ushahidi, Project Liberty Institute,
the Engelberg Center, the Global Solutions Initiative, and the AI
Disclosures Project, CC will be adding to conversations that
governments, the European Union, and the United Nations have been having
this year.
Open
source and digital sovereignty are closely related. While open source
does not suffice for digital sovereignty, it is a critical building
block. While definitions of digital sovereignty vary, it is generally
accepted that digital sovereignty at the national level entails the
ability to independently control everything from infrastructure, to
hardware, to software, to data.
The day’s conversations will work through questions including:
Where are open practices complementary, and where is there friction?
How does this vary at different levels of the open stack—from infrastructure, to software, to data?
What can we learn from conceptions of sovereignty at the individual and community level?
How does Middle Power Collaboration enter the equation?
Panels will explore the full range of these questions, leaving participants with examples of open collaboration.
Logistics
NYU Engelberg Center, Lipton Hall at D’Agostino Hall, 108 West 3rd Street, New York.
Monday, September 21, 2026
10:00 am to 3:00 pm. (doors open at 9:30 am.; lunch will be provided midday.)
Chúng tôi rất vui mừng được thông báo rằng chúng tôi sẽ hỗ trợ bốn sự kiện khu vực nhân dịp kỷ niệm 25 năm thành lập Creative Commons (CC)—đại
diện cho các khu vực trên toàn thế giới với sự tham gia của các nhóm
đang nỗ lực thúc đẩy tri thức mở. Chúng tôi rất hân hạnh được hợp tác
với nhiều đối tác uy tín và mong muốn chia sẻ thêm về kế hoạch của họ
cũng như cập nhật kết quả sau khi các sự kiện này diễn ra.
Chúng
tôi xin gửi lời cảm ơn đến tất cả những ai đã gửi đề xuất tổ chức sự
kiện. Đã có rất nhiều ý tưởng tuyệt vời, và chúng tôi hy vọng sẽ có thêm
cơ hội hỗ trợ các hoạt động khu vực như thế này trong tương lai.
Kỷ niệm 25 năm Creative Commons | Argentina
Tại
Córdoba, LibreBase sẽ tổ chức kỷ niệm 25 năm Creative Commons cùng với
các cộng đồng lâu năm tại Argentina hoạt động trong các lĩnh vực văn hóa
tự do (cultura libre), phần mềm tự do và tri thức mở. Sự
kiện kéo dài một ngày này sẽ quy tụ các nhà sáng tạo, nhà giáo dục, nhà
nghiên cứu, nhà xuất bản, chuyên gia công nghệ và các nhà hoạt động xã
hội để cùng thảo luận và tham gia các hội thảo thực hành, nhằm khám phá
tác động của việc cấp phép mở đối với văn hóa, giáo dục và tri thức.
Người tham gia có thể khám phá khu vực trưng bày và trao đổi kỹ thuật
số các tác phẩm được cấp phép CC, tìm hiểu về việc phối lại (remix) và
Wikimedia Commons, cũng như tham gia phiên thảo luận bế mạc về tương lai
của "tài sản chung kỹ thuật số" (digital commons), bao gồm các vấn đề
mới nổi liên quan đến trí tuệ nhân tạo tạo sinh (generative AI).
Tôn vinh Tài sản chung (Commons) thông qua Ngôn ngữ Bản địa | Ấn Độ
Được
tổ chức song song với sự kiện WikiConference India 2026 tại Kochi,
OpenSpeaks sẽ kỷ niệm 25 năm thành lập Creative Commons bằng cách tập
trung vào các ngôn ngữ bản địa, kho lưu trữ cộng đồng và tri thức chung
(knowledge commons). Sự kiện này kết nối các thành viên cộng đồng
Wikimedia, chuyên gia lưu trữ, các chuyên gia trong lĩnh vực GLAM (phòng
trưng bày, thư viện, kho lưu trữ, bảo tàng) và các nhà hoạt động ngôn
ngữ thông qua chương trình hội thảo trực tuyến kéo dài sáu tháng. Chương
trình sẽ khép lại bằng một buổi gặp mặt trực tiếp, ra mắt liên minh tài
liệu ngôn ngữ do cộng đồng dẫn dắt và xây dựng nguồn tài nguyên giáo
dục mở dành cho các giảng viên tương lai. Bằng
cách hỗ trợ các cộng đồng ghi lại và cấp phép mở cho tri thức bằng hơn
60 ngôn ngữ, sự kiện làm nổi bật vai trò của Creative Commons trong việc
bảo tồn di sản văn hóa và duy trì sức sống trực tuyến cho các ngôn ngữ
của các nhóm yếu thế.
Mở rộng Chân trời Mở: Creative Commons dành cho Nhà giáo dục Indonesia | Indonesia
Nhóm
Open Horizons sẽ mang sự kiện kỷ niệm 25 năm thành lập Creative Commons
đến với các nhà giáo dục khắp Indonesia thông qua chuỗi hội thảo cộng
đồng tại bảy thành phố. Các giáo viên, giảng viên đại học và những người
thực hành giáo dục mở sẽ được tìm hiểu về bản quyền, việc cấp phép
Creative Commons, cũng như cách tạo lập và chia sẻ Tài nguyên Giáo dục
Mở (OER); đồng thời, các điều phối viên tại địa phương cũng sẽ được đào
tạo để tiếp nối và phát triển công việc này. Chương trình sẽ khép lại
bằng một lễ kỷ niệm tại Yogyakarta, bao gồm tọa đàm, triển lãm và hội
thảo, nơi người tham gia sẽ đóng góp hơn 100 tác phẩm được cấp phép
mở—ghi lại các khía cạnh về giáo dục và văn hóa địa phương—vào kho dữ
liệu Wikimedia Commons.
Lễ kỷ niệm 25 năm Creative Commons tại Nigeria | Nigeria
Tại
Ilorin, nhóm CC25 Nigeria sẽ quy tụ những người ủng hộ tri thức mở, thủ
thư, nhà giáo dục, người làm sáng tạo, chuyên gia bản quyền và các cộng
tác viên Wikimedia để cùng tham gia lễ kỷ niệm 25 năm Creative Commons
đầy sôi nổi và mang tính tương tác cao. Sự kiện sẽ kết hợp nhiều hoạt
động đa dạng: triển lãm hình ảnh "Phòng trưng bày các Tài nguyên chung"
(Commons Gallery), các cuộc thảo luận cộng đồng và bài thuyết trình ngắn
(lightning talks), vinh danh những cá nhân tiên phong trong lĩnh vực
tri thức mở tại Nigeria, cùng một hội thảo thực hành nơi người tham gia
có thể học cách cấp phép mở cho chính các tác phẩm của mình. Cùng nhau,
những người tham gia sẽ nhìn lại chặng đường 25 năm của tính mở tại
Nigeria và hình dung về tương lai của hoạt động chia sẻ trong 25 năm
tới.
Nếu bạn muốn tổ chức sự kiện kỷ
niệm 25 năm Creative Commons và đã có sẵn kinh phí thực hiện, chúng tôi
rất mong nhận được tin từ bạn! Hãy cho chúng tôi biết bằng cách gắn thẻ
(tag) chúng tôi trên mạng xã hội hoặc chia sẻ thông tin trên diễn đàn
cộng đồng Zulip!
Chúng tôi vô cùng trân trọng những nỗ lực tuyệt vời mà các bạn đã bỏ ra
để lan tỏa tầm ảnh hưởng của Creative Commons trên toàn thế giới, và
rất mong chờ được tiếp tục đồng hành cùng cộng đồng trong 25 năm tới.
We are excited to announce that we will be supporting four regional events for CC’s 25th Anniversary—representing
regions around the world with groups who are working to advance open
knowledge. We’re delighted to be working with a variety of trusted
partners and look forward to sharing more about their plans and
reporting back on how these events went.
We
want to thank everyone who submitted a proposal for an event. There
were so many great ideas, and we hope to have more opportunities to
support regional work like this in the future.
25 Years of Creative Commons | Argentina
In
Córdoba, LibreBase will celebrate 25 years of Creative Commons
alongside Argentina’s longstanding cultura libre, free software, and
open knowledge communities. The one-day gathering will bring together
creators, educators, researchers, publishers, technologists, and
activists for conversations and hands-on workshops exploring the impact
of open licensing across culture, education, and knowledge. Participants
can explore a showcase and digital swap of CC-licensed works, learn
about remixing and Wikimedia Commons, and join a closing conversation on
the future of the digital commons including emerging questions around
generative AI.
Celebrating the Commons Through Indigenous Languages | India
Co-located
with WikiConference India 2026 in Kochi, OpenSpeaks will celebrate
Creative Commons’ 25th anniversary by centering Indigenous languages,
community archives, and the knowledge commons. The celebration brings
together Wikimedians, archivists, GLAM practitioners, and language
activists through a six-month program of online workshops culminating in
an in-person gathering, the launch of a community-led language
documentation consortium, and the creation of an open educational
resource for future trainers. By supporting communities to document and
openly license knowledge in more than 60 languages, the event highlights
how Creative Commons can help preserve cultural heritage and keep
marginalized languages thriving online.
Expanding Open Horizons: Creative Commons for Indonesia’s Educators | Indonesia
The
Open Horizons team will bring Creative Commons’ 25th anniversary to
educators across Indonesia through a series of community-based workshops
in seven cities. Teachers, university lecturers, and open education
practitioners will learn about copyright, Creative Commons licensing,
and creating and sharing Open Educational Resources, with local
facilitators trained to carry the work forward. The program will
culminate in a celebration in Yogyakarta, featuring a talk show,
showcase, and workshop, with participants contributing more than 100
openly licensed works documenting education and local culture to
Wikimedia Commons.
A Nigerian Celebration of 25 Years of the Commons | Nigeria
In
Ilorin, the CC25 Nigeria team will bring together open knowledge
advocates, librarians, educators, creatives, copyright experts, and
Wikimedia contributors for a festive and participatory celebration of 25
years of Creative Commons. The event will combine a visual “Commons
Gallery,” community conversations and lightning talks, recognition of
Nigerian open knowledge leaders, and a hands-on workshop where
participants can learn to openly license their own work. Together,
participants will reflect on the past 25 years of openness in Nigeria
and imagine what the next 25 years of sharing can look like.
If
you would like to host a celebration for CC’s 25th and have your own
funding to do so, we’d love to hear from you! Let us know by tagging us
on social media or by sharing on our community forum Zulip!
We are so grateful for the incredible work you’ve all done to amplify
CC’s impact around the world, and look forward to the next 25 years of
community engagement with you.