Chủ Nhật, 4 tháng 10, 2026

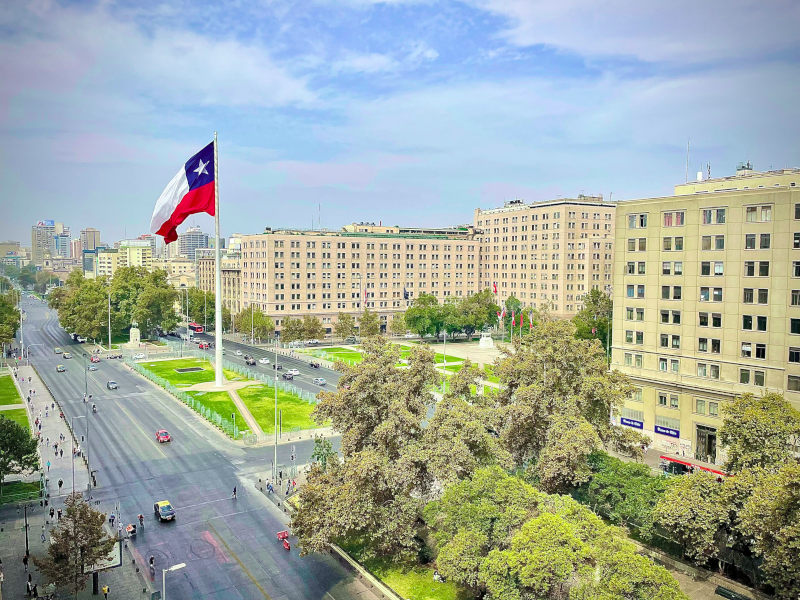
Chile ra mắt mô hình AI nguồn mở đầu tiên được thiết kế cho các nền văn hóa Mỹ Latinh


Chile ra mắt mô hình AI nguồn mở đầu tiên được thiết kế cho các nền văn hóa Mỹ Latinh

Chile launches the first open source AI model designed for Latin American cultures

by Sofia Linna, Published on: 01/10/2026

Theo: https://interoperable-europe.ec.europa.eu/collection/open-source-observatory-osor/news/chile-launches-open-source-ai-model-latam-gpt

Bài được đưa lên Internet ngày: 01/10/2026

Các mô hình AI đang thay đổi cách chúng ta sáng tạo, chia sẻ và gìn giữ văn hóa. Đồng thời, vấn đề thiếu sự đa dạng (hay tính đồng nhất) nảy sinh khi các mô hình chủ yếu được huấn luyện bằng dữ liệu tiếng Anh và đưa ra thông tin sai lệch về thực tế tại các khu vực khác nhau. Nếu được phát triển với tinh thần bao trùm và đa dạng, các mô hình ngôn ngữ lớn (LLM) có tiềm năng thực sự trong việc mở rộng khả năng tiếp cận, bảo tồn di sản, tăng cường sự hiện diện của các nền văn hóa đa dạng và khơi nguồn cho những hình thức sáng tạo mới. Đây chính là ý tưởng cốt lõi đằng sau Latam-GPT.

Latam-GPT là mô hình ngôn ngữ lớn (LLM) nguồn mở đầu tiên của Chile được huấn luyện dựa trên các nền văn hóa Mỹ Latinh. Mô hình AI này lần đầu tiên được công bố vào tháng 2 năm 2026 tại Hội nghị Thượng đỉnh Hành động về Trí tuệ Nhân tạo ở Paris, nhưng quá trình phát triển đã bắt đầu từ khoảng năm 2023, khi một nhóm nghiên cứu tại Trung tâm Quốc gia về Trí tuệ Nhân tạo (CENIA) của Chile bắt đầu tìm cách xây dựng một LLM dành riêng cho khu vực dựa trên các mô hình AI nguồn mở hiện có sẵn.

Ngay từ đầu, nhóm nghiên cứu tại CENIA đã mong muốn "học hỏi và xây dựng một nền tảng nguồn mở, chú trọng đặc biệt đến những khác biệt về ngôn ngữ văn hóa, cũng như lịch sử văn hóa và các quan điểm đa dạng trong khu vực Mỹ Latinh", bà Gabriela Arriagada Bruneau – nhà nghiên cứu liên kết tại CENIA kiêm phó giáo sư về AI và đạo đức dữ liệu tại Đại học Công giáo Giáo hoàng Chile – giải thích.

Khắc phục khoảng cách về sự hiện diện văn hóa

Latam-GPT không có ý định cạnh tranh với ChatGPT, Google Gemini hay các công cụ phổ thông tương tự. Thay vào đó, mô hình này hướng tới việc cung cấp một cơ sở hạ tầng nền tảng chính xác và hiệu quả hơn để phát triển thêm các ứng dụng AI dành riêng cho khu vực. Tầm nhìn đằng sau mô hình này trở nên rõ ràng khi nhóm nghiên cứu tại CENIA xem xét dữ liệu của các LLM phổ biến hiện nay.

"Chúng tôi muốn đánh giá mức độ hiện diện của các nền văn hóa, và kết quả cho thấy chưa đến 2% tổng số dữ liệu huấn luyện mà chúng tôi khảo sát có chứa dữ liệu thực tế bằng tiếng Tây Ban Nha hoặc tiếng Bồ Đào Nha", bà Arriagada Bruneau giải thích.

Nhóm nghiên cứu cũng nhận thấy những vấn đề vượt xa phạm vi chỉ đơn thuần là gia tăng nội dung tiếng Tây Ban Nha và tiếng Bồ Đào Nha. Một vấn đề quan trọng khác liên quan đến cách các mô hình AI thể hiện những khác biệt về lịch sử và văn hóa trong khu vực Mỹ Latinh.

Cô nói: “Vấn đề không chỉ là xử lý ngôn ngữ mà còn là những câu hỏi sâu sắc hơn. "Một mô hình nên đề cập đến những khác biệt trong lịch sử như thế nào? Chúng tôi biết rằng cách bạn đào tạo mô hình và cách thức bạn đặt bất kỳ loại bộ lọc hoặc điểm chuẩn nào sẽ có tác động đến cách đầu ra sẽ thể hiện những điều đó."

Để giải quyết hiệu quả những vấn đề này, dự án chủ yếu dựa vào sự hợp tác. CENIA làm việc với các đối tác từ hơn 20 quốc gia Mỹ Latinh, bao gồm các đơn vị học thuật và chính phủ, các tổ chức phi lợi nhuận và cộng đồng địa phương.

Kiểm tra kiến thức thông qua sự tham gia của cộng đồng vào các điểm chuẩn

Cách tiếp cận hợp tác của Latam-GPT cũng đang định hình cách đánh giá mô hình. Bằng cách phát triển các tiêu chuẩn riêng của mình, nhóm có thể kiểm tra mức độ mà các mô hình ngôn ngữ hiểu chính xác kiến ​​thức của khu vực.

Arriagada Bruneau nói: “Chúng tôi đã xây dựng các tiêu chuẩn và tôi nghĩ đây là một cách học tập rất hay”. “Nó đã trở thành một sự đón nhận rất tốt đẹp của cộng đồng về cách chúng tôi nghĩ về các mô hình ngôn ngữ.”

Một trong số đó là Choclo, một chuẩn mực nguồn mở tập trung vào kiến ​​thức văn hóa Mỹ Latinh. Choclo có ý định nắm bắt sự phong phú, đa dạng và đặc trưng của kiến ​​thức văn hóa Mỹ Latinh. Nó chứa hơn 100.000 hàng câu hỏi bao gồm các chủ đề như địa lý, động vật, thực vật, truyền thống, ẩm thực và nhân vật công chúng. Cách tiếp cận này không chỉ là về kiến ​​thức chung mà LLM thường thu được từ Internet mà còn về việc thu hút mọi người cung cấp kiến ​​thức này.

Ngoài Choclo, nhóm còn phát triển tiêu chuẩn nguồn mở Trueque, bao gồm 500 câu hỏi được tuyển chọn để kiểm tra kiến ​​thức thực tế và sự phù hợp về văn hóa. Để đào tạo thêm Latam-GPT, nền tảng trò chuyện tương tác thử nghiệm Copuchat đã được tạo ra để đào tạo mô hình.

Tính mở, quản trị dữ liệu và đạo đức AI

Như Arriagada Bruneau giải thích, tính mở là trọng tâm của dự án, bao gồm cả nguồn mở và trọng số mở (Open Source and Open Weights). Nhóm cũng đang tập trung vào các câu hỏi xung quanh quản trị dữ liệu và đạo đức AI, bao gồm tính minh bạch, quyền riêng tư, thành kiến ​​và đa dạng ngôn ngữ.

“Chúng tôi áp dụng những gì có thể gọi là ‘các nguyên tắc đạo đức truyền thống’ – bao gồm tính minh bạch, trách nhiệm, sự công bằng và việc tính đến các yếu tố thiên kiến,” bà chia sẻ. “Tuy nhiên, chúng tôi cũng cân nhắc, chẳng hạn như các tiêu chí về sự đa dạng ngôn ngữ.”

Phối hợp cùng nhóm GobLab UAI, đội ngũ tại CENIA đã xây dựng một bản công bố thông tin minh bạch, trong đó trình bày chi tiết cơ sở lý giải cho các biện pháp can thiệp dữ liệu của dự án cũng như các tiêu chuẩn về quyền riêng tư được tuân thủ. Do quy định về AI tại Chile còn hạn chế, phần lớn khuôn khổ về AI có trách nhiệm của dự án đều dựa trên cam kết của chính nhóm thực hiện đối với tính mở và đạo đức trong lĩnh vực AI.

Giai đoạn hai: tăng cường năng lực cho Latam-GPT và đẩy mạnh hợp tác khu vực

Khi dự án bước sang giai đoạn hai, trọng tâm được đặt vào việc củng cố khả năng suy luận và giải quyết vấn đề của Latam-GPT, cũng như mở rộng quá trình huấn luyện dựa trên các yếu tố ngữ cảnh. CENIA cũng đang hợp tác với các nhà nhân học, xã hội học và đại diện tư vấn từ nhiều cộng đồng bản địa để tìm kiếm khả năng tích hợp ngôn ngữ và tri thức bản địa vào hệ thống.

Nhằm tăng cường hơn nữa sự hợp tác trong khu vực, nhóm đang xây dựng một liên minh chiến lược với Brazil. Những mối quan hệ hợp tác này không chỉ giúp dự án mở rộng năng lực kỹ thuật mà còn góp phần thách thức quan niệm cho rằng việc phát triển AI bắt buộc phải tuân theo một lộ trình định sẵn.

Đây có thể chính là một trong những đóng góp quan trọng nhất của Latam-GPT. Dự án không chỉ đơn thuần bổ sung dữ liệu từ Mỹ Latinh vào các mô hình AI mà còn tập trung khám phá ý nghĩa thực sự của việc phát triển một mô hình ngay tại khu vực này: “có nhiều cách khác nhau để chúng ta làm chủ công nghệ, biến nó thành công cụ phục vụ nhu cầu và bối cảnh thực tế của các nhóm cộng đồng khác nhau”.

AI models are transforming how we create, share and preserve culture. At the same time, there is a homogeneity issue when models are trained on primarily English data and present biased information about regional realities. When developed with inclusivity in mind, large language models (LLMs) have a real potential to expand access, preserve heritage, strengthen diverse representation and inspire new forms of creativity. This is exactly the idea behind Latam-GPT. 

Latam-GPT represents Chile's first open source LLM trained by the cultures of Latin America. The AI model was first announced in February 2026 at the Artificial Intelligence Action Summit in Paris, but its development started around 2023 when a research team at the National Center of Artificial Intelligence (CENIA) in Chile began exploring ways to develop a regional-specific LLM built on existing open source AI models. 

Right from the beginning, the team at CENIA wanted to “learn and build a platform that was open source and that paid attention specifically to the cultural language-based difference, but also the cultural history and points of view within the Latin American region”, explains Gabriela Arriagada Bruneau, Associate Researcher at CENIA and assistant professor in AI and data ethics at the Pontifical Catholic University of Chile. 

Addressing the representation gap 

Latam-GPT does not intend to compete with ChatGPT, Google Gemini and similar consumer tools. Instead, the model aims to offer a more accurate and efficient foundational infrastructure for the further development of regional AI applications. The vision behind the model became clear when the team at CENIA examined the data behind popular LLMs. 

“We wanted to see what level of representation existed, and roughly under two percent of all the training data and training models we considered contained actual Spanish or Portuguese data”, Arriagada Bruneau explains. 

The team also identified issues that went beyond simply increasing Spanish and Portuguese content. Another key issue was linked to how AI models represent historical and cultural differences within Latin America. 

“It was not just about processing language, but also more profound questions,” she says. “How should a model refer to historical differences? We know that how you train the model and how you put any type of filtering or benchmarks is going to have an impact on how the output is going to represent those things.”

To efficiently address these issues, the project relies heavily on collaboration. CENIA works with partners from more than 20 Latin American countries, including academic and governmental institutions, non-profit organisations and local communities. 

Knowledge testing through community engagement in benchmarks 

Latam-GPT’s collaborative approach is also shaping how the model is evaluated. By developing its own benchmarks, the team is able to test the extent to which language models accurately understand regional knowledge. 

“We’ve built benchmarks, and I think this has been a very beautiful way of learning,” says Arriagada Bruneau. “It has come up as a very nice community embrace of how we think about language models.”

One of these is Choclo, an open source benchmark centered around Latin American cultural knowledge. Choclo intends to capture the richness, diversity and specificity of Latin American cultural knowledge. It contains over 100,000 rows of questions covering topics such as geography, fauna, flora, traditions, gastronomy and public figures. This approach is not just about general knowledge that LLMs normally acquire from the internet, but also about engaging people to provide this knowledge. 

Besides Choclo, the team also developed the open source benchmark Trueque, consisting of 500 curated questions to test factual knowledge and cultural appropriateness. To further train Latam-GPT, the experimental interactive chat platform Copuchat was created to train the model.

Openness, data governance and AI ethics 

As explained by Arriagada Bruneau, openness is central to the project, which includes both open source and open weights. The team is also focusing on questions around data governance and AI ethics, including transparency, privacy, bias and linguistic diversity.

“You have what I would call ‘traditional ethical principles’ – transparency, responsibility, fairness, accounting for bias” she says. “But we also considered, for example, criteria for linguistic diversity”. 

The team at CENIA have also developed a transparency sheet detailing the reasoning behind the project’s data interventions and privacy levels that are being respected, in collaboration with the GobLab UAI team. Because of a limited AI regulation in Chile, much of the project’s responsible AI framework is based on the team’s own commitment to openness and AI ethics. 

Second phase: strengthening Latam-GPT and further regional collaboration 

As the project enters its second phase, the focus is on strengthening the reasoning and problem-solving capabilities of Latam-GPT as well as expanding contextual training. CENIA is also working with anthropologists, sociologists and consulting representatives from various indigenous communities to explore the possibilities to include indigenous languages and knowledge. 

To further strengthen regional collaboration, the team is building a strategic alliance with Brazil. Such collaborations allow the project to expand its technical capabilities, but they also help challenge the assumption that AI development has to follow a predetermined path. 

This may ultimately be one of Latam-GPT’s most important contributions. The project moves away from simply adding more Latin American data to AI models and instead focuses on exploring what it actually means to develop a model within the region: “there are different ways in which we can make technology our own to serve the needs and the contexts of different people”. 

Dịch: Lê Trung Nghĩa

letrungnghia.foss@gmail.com

Thứ Năm, 1 tháng 10, 2026

Di sản Mở trong Kỷ nguyên trí tuệ nhân tạo


Di sản Mở trong Kỷ nguyên trí tuệ nhân tạo

"Χωρίς τίτλο" by Stefanos Michaelides, 2011, Metropolitan Organisation of Museums of Visual Arts of Thessaloniki, is licensed under CC BY-SA 4.0.

Open Heritage in the Age of Artificial Intelligence

Posted 19 August 2026 by Brigitte Vézina, Sarah Hinchliff Pearson

Theo: https://creativecommons.org/2026/08/19/open-heritage-in-the-age-of-artificial-intelligence/

Bài được đưa lên Internet ngày: 19/08/2025

Giá trị to lớn của việc chia sẻ di sản

Các cơ sở di sản văn hóa - CHI (Cultural Heritage Institutions) – như bảo tàng, thư viện và kho lưu trữ – gánh vác sứ mệnh quan trọng vì lợi ích công cộng là tạo điều kiện cho công chúng tiếp cận các di sản trong bộ sưu tập của mình. Sứ mệnh này dựa trên nền tảng là sự tiếp cận rộng rãi của công chúng và sự tham gia tích cực của con người, sự tồn tại của tài nguyên chung về văn hóa (cultural commons) sống động, cũng như việc coi di sản là nguồn tài nguyên được chia sẻ. Các CHI hiểu rằng, với tư cách là sự phản ánh bản sắc của chúng ta, di sản góp phần định hình giá trị nhân văn chung; đồng thời, việc tạo điều kiện tiếp cận di sản mang lại vô số lợi ích (bản dịch sang tiếng Việt) cho xã hội. Do đó, với vai trò là những người gìn giữ nguồn thông tin đáng tin cậy chứa đựng tri thức và văn hóa, các CHI có vai trò then chốt trong việc phát triển và bảo vệ kho tàng chung này, cũng như thúc đẩy các hoạt động sử dụng mang lại lợi ích cho nhân loại.

AI – Yếu tố gây biến động mạnh mẽ

Sự xuất hiện gần đây của trí tuệ nhân tạo (AI) tạo sinh đã tạo ra tác động to lớn đối với các CHI, đặc biệt là khi các nội dung do họ quản lý được truy cập và sử dụng để phát triển AI. Một vấn đề trọng tâm được đặt ra là các điều kiện, quy tắc và kỳ vọng chi phối việc sử dụng các tư liệu di sản văn hóa – vốn thuộc phạm vi công cộng hoặc được cấp phép mở – làm dữ liệu để phát triển AI. Các ví dụ điển hình bao gồm các bộ dữ liệu mở tại AI4Culture, BigLAM của Hugging Face, Institutional Books của Harvard, The Public Interest Corpus của Authors’ Alliance, cũng như European Books Data Commons (dự kiến ​​trong tương lai). Thực tế này đang thúc đẩy các cuộc thảo luận về việc ai có quyền truy cập và tái sử dụng các dữ liệu đó, cũng như mục đích của việc sử dụng này. Nhờ vào trách nhiệm quản lý và gìn giữ, các bộ sưu tập di sản thường cung cấp những bộ dữ liệu đa dạng, chất lượng cao, có bối cảnh rõ ràng và được tuyển chọn kỹ lưỡng. Mặc dù việc đưa dữ liệu từ các bộ sưu tập di sản vào quy trình phát triển hứa hẹn tạo ra các hệ thống AI ưu việt và mang tính đại diện cao hơn, các CHI vẫn phải đối mặt với nhiều thách thức, bao gồm:

Nhìn bề ngoài, điều này cho thấy sự xung đột giữa các hoạt động phát triển AI thương mại với cam kết cung cấp quyền truy cập mở của các tổ chức di sản văn hóa (CHI), cũng như những kỳ vọng dựa trên mô hình tài nguyên chung về sự tương hỗ có đi có lại (bản dịch sang tiếng Việt) và tôn trọng “khế ước xã hội” làm nền tảng cho việc chia sẻ các tài nguyên chung (commons) về di sản. Nó cho thấy niềm tin đang dần bị xói mòn. Và tất cả những điều này diễn ra trong bối cảnh có nhiều bất định về mặt pháp lý liên quan đến bản quyền cũng như việc áp dụng các giấy phép và công cụ của Creative Commons (CC). 

Các tổ chức di sản văn hóa (CHI) ngày càng ngần ngại chia sẻ các tài nguyên chung 

Chúng ta có thể hình dung các phản ứng đối với hoạt động thu thập dữ liệu (scraping) của AI trên một dải phổ, từ việc cởi mở đón nhận rộng rãi cho đến thái độ phòng thủ, khép kín để bảo vệ dữ liệu. Điều này được phản ánh rõ nét trong báo cáo Making Public AI reality: How cultural heritage can lead the way (bản dịch sang tiếng Việt) của Europeana; báo cáo này xác định hai nhóm ở hai thái cực đối lập: nhóm thiết lập ranh giới và nhóm tìm kiếm cơ hội. Sự xuất hiện của lưu lượng truy cập từ AI về cơ bản đặt các tổ chức di sản văn hóa trước hai lựa chọn:

  • Cho phép mọi nhà phát triển AI khai thác dữ liệu không giới hạn, hoặc

  • Hạn chế quyền truy cập theo những cách thô bạo và quá mức cần thiết (“đóng kín mang tính phòng thủ”).

Trên thực tế, một số cơ sở — ví dụ như Thư viện Quốc gia Hà Lan và Trove (API truy cập mở của Thư viện Quốc gia Úc; xem tại đây và tại đây)—đã phản ứng bằng cách đóng lại quyền truy cập, qua đó bộc lộ một nghịch lý: các tổ chức di sản văn hóa (CHI)—vốn có sứ mệnh chia sẻ các bộ sưu tập của mình—cuối cùng lại đi đến việc khóa chặt di sản. Tình thế tiến thoái lưỡng nan này đang làm lung lay nền tảng vốn đã mong manh của mô hình di sản mở, khi những nội dung lẽ ra được công khai rộng rãi nay lại bị hạn chế chặt chẽ hơn, khiến quyền tiếp cận di sản vì lợi ích công cộng trở thành nạn nhân bị ảnh hưởng. Quả thực, sự căng thẳng này đã được ghi nhận trong Tuyên bố về Di sản Mở (Open Heritage Statement) (bản dịch sang tiếng Việt và bản toàn văn tiếng Việt). Cần nhắc lại rằng, khái niệm di sản mở khuyến khích việc tiếp cận và tái sử dụng di sản mà không vấp phải những rào cản bất hợp lý hay không cần thiết; đồng thời, khái niệm này cũng thừa nhận rằng tính mở không phải là điều gì đó tuyệt đối hay cứng nhắc, đồng nhất. Phần mở đầu của Tuyên bố nhấn mạnh đến trí tuệ nhân tạo (AI) có đạo đức và có trách nhiệm, đồng thời nêu rõ:

Chúng tôi chú trọng đến những thách thức và cơ hội do các công nghệ mới nổi mang lại—bao gồm trí tuệ nhân tạo và các công nghệ trong tương lai—cũng như nhu cầu về công nghệ trí tuệ nhân tạo có đạo đức và trách nhiệm hơn trong việc tiếp cận và tái sử dụng các di sản thuộc phạm vi công cộng.

Đây là lời nhắc nhở kịp thời rằng khi các tổ chức di sản văn hóa (CHI) áp dụng tinh thần mở, đó là một phương tiện để đạt được mục tiêu chứ không phải mở chỉ vì mục đích mở đơn thuần. Các CHI thường thực hiện tinh thần mở dựa trên những nguyên tắc cốt lõi—những nguyên tắc coi trọng tính đa chiều, bối cảnh cụ thể và sự tương tác giữa các khuôn khổ quản trị khác nhau. Tuy nhiên, việc đóng kín hoàn toàn không phải là giải pháp (cách làm này, ở mức độ tốt nhất thì kém hiệu quả, còn ở mức độ tệ nhất thì gây hại cho lợi ích công cộng) và có nguy cơ phá bỏ thành quả của hơn 20 năm phát triển di sản mở thông qua việc sử dụng các giấy phép và công cụ Creative Commons (CC) (bản dịch sang tiếng Việt). Do đó, chúng ta cần vượt qua mô hình đóng kín mang tính phản ứng tức thời để hướng tới một trạng thái cân bằng bền vững hơn trong việc chia sẻ.

Từ sự phân mảnh đến mô hình tài nguyên chung bền vững

Chúng ta biết rằng nhiều cơ sở di sản văn hóa (CHI) mong muốn tiếp tục chia sẻ các bộ sưu tập của mình, đồng thời đảm bảo rằng các nhà phát triển AI sử dụng chúng một cách có trách nhiệm. Trong bối cảnh đó, làm thế nào để các CHI có thể cung cấp quyền truy cập mở và công bằng vào các bộ sưu tập di sản của mình theo cách phù hợp với sứ mệnh là những người quản lý có trách nhiệm? Làm thế nào để các CHI có thể “chủ động định hình các điều kiện mà tại đó các bộ sưu tập của họ được các hệ thống AI truy cập và tái sử dụng, mà không làm ảnh hưởng đến cam kết về tính mở” như Open Future và Europeana đã nêu? (bản dịch sang tiếng Việt) Cụ thể hơn, dữ liệu di sản nên được cung cấp để huấn luyện và sử dụng cho AI trong những điều kiện nào? Bởi ai? Và vì mục đích gì?

Để giải quyết những vấn đề này, CC đang phát triển CC Signals – một bộ công cụ mới giúp khôi phục quyền chủ động của các tổ chức di sản văn hóa (CHI) với tư cách là những người quản lý dữ liệu, đồng thời duy trì tính mở của di sản được chia sẻ trong các tài nguyên chung (commons). CC Signals sẽ nỗ lực cân bằng giữa hai mục tiêu:

  • Duy trì quyền truy cập tới các nguồn tài nguyên di sản quý giá, và

  • Đảm bảo rằng các cơ sở và cộng đồng quản lý những di sản này vẫn là những bên tham gia tích cực vào việc định hình hệ sinh thái AI.

Bộ công cụ CC Signals sẽ tạo ra một giải pháp trung dung, vượt qua thế lưỡng nan hiện tại giữa việc "miễn phí cho mọi người" và "đóng kín để bảo vệ". CC Signals thực hiện điều này bằng cách thiết lập các điều kiện chuẩn hóa, mang tính tích cực cho xã hội (prosocial) đối với việc truy cập và tái sử dụng trong bối cảnh AI. Là một phần của nỗ lực này, CC đang nghiên cứu các phương án kết hợp luật hợp đồng và luật bản quyền để tạo cơ sở pháp lý cho CC Signals. Mọi hình thức của CC Signals đều sẽ bao gồm các biện pháp bảo vệ việc tái sử dụng vì lợi ích công cộng. Nói một cách đơn giản, CC Signals sẽ thiết lập và duy trì những ranh giới cần thiết mà các nguồn tài nguyên chung (commons) cần để phát triển mạnh mẽ. Các tổ chức di sản văn hóa (CHI) có vị thế thuận lợi để thử nghiệm và triển khai CC Signals như một phần của các khuôn khổ đạo đức về chia sẻ di sản trong các tài nguyên chung phục vụ cho AI. CHI là những nhân tố then chốt giúp định hình một hệ sinh thái AI thúc đẩy sự hợp tác, đảm bảo quyền tiếp cận công bằng và mang lại lợi ích công cộng lâu dài.

Bạn có thể đóng góp như thế nào?

Mặc dù chưa có lời giải đáp cho mọi vấn đề, chúng tôi hiểu rằng cần bắt đầu những cuộc thảo luận mang tầm nhìn lớn để đảm bảo tiếng nói của các cơ sở di sản văn hóa (CHI) được lắng nghe và định hướng thế giới đang ngày càng bị AI chi phối. Ngay hôm nay, bạn có thể góp phần định hình một hệ thống AI hỗ trợ di sản mở:

The Prodigious Value of Sharing Heritage

Cultural heritage institutions (CHIs) such as museums, libraries, and archives, carry the important public-interest mission of providing access to the heritage in their collections. Their mission is grounded in broad public access and extensive human engagement, the existence of a vibrant cultural commons, and heritage enjoyed as a shared resource. CHIs understand that, as a representation of who we are, heritage helps define our shared humanity and that providing access to heritage generates numerous benefits for society. As such, CHIs, as stewards of trustworthy information imbued within knowledge and culture, have a crucial role to play in growing and protecting the commons and enabling uses that benefit humanity. 

AI—the Major Disruptor 

The recent emergence of generative artificial intelligence (AI) has had a phenomenal impact on CHIs, especially as the content they steward is accessed and used for AI development. One key question centers on the conditions, norms, and expectations governing the use of openly licensed and public domain cultural heritage materials as data for AI development. Examples include the open datasets available at AI4Culture, Hugging Face’s BigLAM, Harvard’s Institutional Books, Authors’ Alliance The Public Interest Corpus, as well as, potentially in the future, the European Books Data Commons. This is prompting discussions around who can access and reuse those data, and for what purpose. Heritage collections often yield—by virtue of the stewardship duties that underpin them—diverse, high-quality, contextualized, and well-curated datasets. While inclusion of heritage collections data could expectedly yield better, more representative AI systems, CHIs face many challenges, including: 

On the surface, this points to a conflict between the practices of commercial AI developments and CHIs’ commitment to provide open access and commons-based expectations of reciprocity and respect for the social contract underpinning sharing of heritage in the commons. It reveals how trust is slowly being eroded. And all this is happening against a backdrop of high legal uncertainty around copyright and, by the same token, the application of CC licenses and tools.

CHIs More Hesitant to Share in the Commons

We can map reactions to AI scraping along a spectrum from wide embrace to protective, defensive closing up. This is well reflected in Europeana’s report Making Public AI reality: How cultural heritage can lead the way, which identifies two groups at each end: boundary setters and opportunity seekers. The onset of AI traffic basically leaves CHIs with two options: 

  • Allow unrestricted extraction by all AI developers, or 

  • Restrict access in blunt and overbroad ways (“defensive enclosure”). 

In fact, some institutions, e.g., the National Library of the Netherlands, and Trove, the National Library of Australia’s open access API (see here and here), have responded by closing up access, revealing a paradox: CHIs, whose mission is to share their collections, end up locking up heritage. This conundrum is rattling the fragile scaffolding of open heritage, as content that would have otherwise been made available openly is now being further restricted, with access to heritage in the public interest as collateral damage. Indeed, this tension is acknowledged in the Open Heritage Statement. To recall, the concept of open heritage encourages access and reuse of heritage free of unfair, unnecessary barriers; it does recognize that openness is neither absolute nor monolithic. The Statement’s preamble paragraph (s) emphasizes ethical and responsible AI and states:  

[W]e are attentive to the challenges and opportunities brought about by emerging technologies, including artificial intelligence and future technologies, and the need for more ethical and responsible artificial intelligence with respect to access and reuse of public domain heritage.

This serves as a timely reminder that when CHIs embrace openness, it is as a means to an end—not open for open’s sake. CHIs often embrace openness in accordance with its underlying principles, which recognize nuance, contextuality, and the interplay among various governance frameworks. That said, closing up completely is not the answer (it’s inefficient at best and harms public interests at worst) and risks undoing 20+ years of open heritage using CC licenses and tools. We thus need to move beyond a reactive enclosure pattern towards a more sustainable sharing equilibrium. 

From Fragmentation to a Sustainable Commons 

We know that many CHIs want to continue sharing their collections while ensuring that AI developers use them responsibly. Against this backdrop, how can CHIs make their heritage collections openly and equitably accessible in a way that aligns with their mission as responsible stewards? How can CHIs “actively shape the conditions under which their collections are accessed and reused by AI systems, without compromising their commitment to openness” as Open Future and Europeana state? More specifically, under what conditions should heritage data be made available for AI training and use? By whom? For what purpose?

As a response to these questions, CC is developing CC Signals, new tooling which will restore agency in CHIs as data stewards, while maintaining the open nature of heritage shared in the commons. CC Signals will attempt a balancing act between: 

  • Preserving access to valuable heritage resources, and 

  • Ensuring that the institutions and communities who steward them remain active participants in shaping the AI ecosystem.  

CC Signals tooling will create a middle path between the current binary of “free for all vs defensive enclosure.” CC Signals will enable this by establishing standardized, prosocial conditions for access and reuse in an AI context. As part of this work, CC is exploring avenues for combining contract and copyright law to give CC Signals legal force. All forms of CC Signals will incorporate protections for public interest reuse.  Put simply, CC Signals would set and uphold the boundaries that the commons needs in order to thrive. CHIs are well positioned to test and implement CC Signals as part of ethical frameworks for sharing heritage in the commons for AI use. CHIs are key actors to help shape an AI ecosystem that fosters collaboration, ensures equitable access, and yields long-term public benefit. 

How You Can Help

While we don’t have all the answers yet, we know we need to start having ambitious conversations to make sure CHIs’ voices inform our increasingly AI-mediated world. Today, you can contribute to shaping the AI that works for open heritage: 

Dịch: Lê Trung Nghĩa

letrungnghia.foss@gmail.com
Thứ Tư, 30 tháng 9, 2026

‘Khung Giáo dục Văn hóa và Nghệ thuật của UNESCO’ - bản dịch sang tiếng Việt


‘Khung Giáo dục Văn hóa và Nghệ thuật của UNESCO’ - bản dịch sang tiếng Việt

Là tài liệu của UNESCO với sự đóng góp từ các Quốc gia Thành viên và Thành viên Liên kết của UNESCO sau Hội nghị Toàn cầu về Giáo dục Văn hóa và Nghệ thuật năm 2024 tại Abu Dhabi.

“ Mục tiêu của Khung

Khung này của UNESCO nhằm cung cấp hướng dẫn và các khuyến nghị chính sách về giáo dục văn hóa và nghệ thuật cho các Quốc gia Thành viên và Thành viên Liên kết vì các mục đích sau:

i. Đảm bảo giáo dục văn hóa và nghệ thuật đóng góp trực tiếp vào việc hiện thực hóa sự phát triển bền vững và hòa bình, phù hợp với các nỗ lực hiện tại và tương lai của Liên Hợp Quốc, bao gồm Chương trình nghị sự 2030 vì sự phát triển bền vững và toàn bộ 17 Mục tiêu Phát triển Bền vững (SDG), đặc biệt là SDG 4 về đảm bảo nền giáo dục chất lượng, hòa nhập và công bằng, đồng thời thúc đẩy cơ hội học tập suốt đời cho tất cả mọi người và SDG 8 về thúc đẩy tăng trưởng kinh tế bền vững và bao trùm, việc làm và công việc bền vững cho tất cả mọi người.

ii. Tận dụng những tiến bộ đương đại và nắm bắt các cơ hội do công nghệ mang lại, đồng thời nhận diện, ngăn ngừa và giảm thiểu rủi ro – đặc biệt là trong lĩnh vực công nghệ kỹ thuật số và Trí tuệ nhân tạo (AI) – nhằm hỗ trợ và thúc đẩy tư duy phản biện, sự sáng tạo, các sáng kiến ​​cũng như việc sử dụng có đạo đức và trách nhiệm trong lĩnh vực này, đặc biệt là vì lợi ích của các ngành giáo dục, văn hóa và sáng tạo.

iii. Lồng ghép hiệu quả giáo dục văn hóa và nghệ thuật vào các chính sách, chiến lược và chương trình có liên quan trong và giữa các ngành văn hóa và giáo dục, bao gồm các quy định, chương trình giảng dạy, công tác đào tạo giáo viên và nhà giáo dục, cũng như các tiêu chuẩn về trình độ và phát triển chuyên môn, hướng tới sự phát triển suốt đời và toàn diện về kiến ​​thức, kỹ năng, thái độ, giá trị và hành vi, chẳng hạn như sự sáng tạo, tư duy phản biện và các kỹ năng nghệ thuật.”

Tự do tải về bản dịch sang tiếng Việt của tài liệu có 22 trang tại địa chỉ:

https://www.dropbox.com/scl/fi/8qf11oljjewdu1mc8a37s/WCCAE_UNESCO-Framework_EN_0_Vi-16092026.pdf?rlkey=e7okn7vovjqqcvwxuba61eo2y&st=r6y6x5gf&dl=0

Xem thêm:

Blogger: Lê Trung Nghĩa

letrungnghia.foss@gmail.com
Thứ Ba, 29 tháng 9, 2026

‘Lập luận về AI Công: Hiện thực hóa thông qua di sản văn hóa’ - bản dịch sang tiếng Việt


‘Lập luận về AI Công: Hiện thực hóa thông qua di sản văn hóa’ - bản dịch sang tiếng Việt

Là bản dịch sang tiếng Việt tài liệu của các tác giả Aldana, L., Oomen, J., Verwayen, H., O’Hare, E., Bocyte, R., Cousins, J., Isaac, A., Matas, A., Sanderhoff, M., Taes, S., & Arnold, K. (2026). Xuất bản tháng 6/2026, giấy phép CC BY-SA.

“Giới thiệu

AI đã trở thành một công nghệ mang tính đột phá, có tác động mạnh mẽ đến đời sống văn hóa - xã hội. Châu Âu đang ở giai đoạn chuyển giao, nơi các quy tắc cũ không còn hoàn toàn phù hợp, trong khi các quy tắc mới vẫn chưa được thiết lập vững chắc. Vào thời điểm này, Châu Âu không cần phải đưa ra lựa chọn sai lầm giữa việc ban hành quy định và thúc đẩy đổi mới sáng tạo. Thay vào đó, khu vực này cần một cách tiếp cận vừa tạo điều kiện cho đổi mới, vừa đảm bảo rằng các công nghệ nền tảng được định hướng bởi các giá trị công thay vì chỉ chịu sự chi phối của lợi ích tư nhân. Nỗi sợ bị tụt hậu không nên trở thành cái cớ để mặc nhiên cho phép lợi ích tư nhân định hình sự phát triển công nghệ. 

Con đường đòi hỏi nhiều nỗ lực hơn – nhưng xét về lâu dài lại là hướng đi đáng mong đợi hơn – cho AI tại Châu Âu nằm ở sự cân bằng: một lộ trình có tính toán kỹ lưỡng, lấy giá trị làm trọng tâm và dựa trên nền tảng thể chế vững chắc. Châu Âu cần xác định một lập trường không chạy theo quan điểm coi AI là cuộc đua bắt buộc phải thắng bằng mọi giá; thay vào đó, cần ưu tiên các giá trị công, nhu cầu cộng đồng và trách nhiệm giải trình dân chủ, thay vì chỉ dựa vào logic thị trường thuần túy hay sự kiểm soát tập trung của nhà nước.

Tài liệu này được cộng đồng chuyên gia thuộc không gian dữ liệu chung của Châu Âu về di sản văn hóa, bao gồm cả Sáng kiến ​​Europeana – đơn vị quản lý không gian dữ liệu này – xây dựng. Nội dung tài liệu phản ánh các cuộc thảo luận từ Hội nghị Đồng thuận về Văn hóa và AI (Alignment Assembly on Culture for AI) – một sáng kiến ​​trí tuệ tập thể đã thu hút sự tham gia của hơn 400 chuyên gia kể từ tháng 5 năm 2025 đến nay. Tài liệu này chủ yếu dành cho lĩnh vực di sản văn hóa Châu Âu. Mặc dù phản ánh quan điểm của cộng đồng không gian dữ liệu, tài liệu cũng đồng thời thể hiện lập trường chung của toàn ngành. Qua đó, tài liệu hướng tới việc đóng góp các giải pháp cụ thể, mang tính thực tiễn nhằm xây dựng một tương lai AI vì lợi ích công cộng tại Châu Âu.”

Tự do tải về bản dịch sang tiếng Việt của tài liệu có 42 trang tại địa chỉ:

https://www.dropbox.com/scl/fi/isi7l236xiw0qpohv532k/The_case_for_Public_AI_PDF_Vi-05092026.pdf?rlkey=pdn61sjoa9eimpiyfrp5l05kl&st=pzcvxih5&dl=0

Xem thêm:

Blogger: Lê Trung Nghĩa

letrungnghia.foss@gmail.com
Thứ Hai, 28 tháng 9, 2026

‘Tổng quan về không gian chung dữ liệu sách châu Âu’ - bản dịch sang tiếng Việt


‘Tổng quan về không gian chung dữ liệu sách châu Âu’ - bản dịch sang tiếng Việt

Là bản dịch sang tiếng Việt tài liệu do tác giả Paul Keller biên soạn, các tổ chức OPEN FUTURE & europeana @2025 xuất bản với giấy phép mở CC BY 4.0.

“Mục đích của Không gian chung dữ liệu sách châu Âu - EBDC (European Books Data Commons)

Về cốt lõi, Không gian chung dữ liệu sách châu Âu (EBDC) là một phần của cơ sở hạ tầng kỹ thuật số công cộng tồn tại để cung cấp quyền truy cập vào các bộ dữ liệu lớn, chất lượng cao về quét sách và toàn văn. Các bộ dữ liệu này được cung cấp miễn phí cho nhiều mục đích sử dụng khác nhau, bao gồm cả ở dạng được tối ưu hóa để đào tạo mô hình AI. EBDC sẽ cung cấp một giao diện tập trung để truy cập dữ liệu, có thể được lưu trữ theo kiểu tập trung hoặc phân tán.

Là một phần của việc này, EBDC sẽ tham gia vào việc làm sạch dữ liệu, ghi nhãn dữ liệu và các hình thức xử lý dữ liệu khác, nhưng sẽ không tham gia vào việc quản lý dữ liệu. Việc quản lý dữ liệu xảy ra ở cấp độ nhà cung cấp dữ liệu (thư viện) hoặc ở cấp độ người dùng EBDC.”

Tự do tải về bản dịch sang tiếng Việt của tài liệu có 12 trang tại địa chỉ:

https://www.dropbox.com/scl/fi/6ni6bspfibz3oh1lcf6xe/251120_Outline_European_Book_Data_Commons-copia_Vi-31082026.pdf?rlkey=xwuudzciaw749gkq4k3tuq0gu&st=h0icm1k3&dl=0

Xem thêm:

Blogger: Lê Trung Nghĩa

letrungnghia.foss@gmail.com
Chủ Nhật, 27 tháng 9, 2026

‘Báo cáo của Nhóm chuyên gia độc lập về Trí tuệ nhân tạo và Văn hóa’ - bản dịch sang tiếng Việt


‘Báo cáo của Nhóm chuyên gia độc lập về Trí tuệ nhân tạo và Văn hóa’ - bản dịch sang tiếng Việt

Là tài liệu của Nhóm Chuyên gia Độc lập về Trí tuệ Nhân tạo và Văn hóa (CULTAI), do UNESCO triệu tập, gồm: Mercedez Bunz, Brendan Ciecko, Salim Dada, Kim Jeong Han, Lethabo Huma, Joe Kallas, Octavio Kulesz, Roman Lipski, Ramon López de Mantaras, Alejandra López Gabrielidis, Ojoma Ochai, và Shrey Maurya, biên tập, được UNESCO & MONDIACULT 25 ESPANA xuất bản năm 2025.

“Tóm tắt:

Nhóm Chuyên gia Độc lập về Trí tuệ Nhân tạo và Văn hóa (CULTAI), do UNESCO thành lập, đã xem xét cách thức AI đang định hình lại sự sáng tạo, di sản và các hệ sinh thái văn hóa trên toàn cầu. Phân tích của Nhóm làm nổi bật một thực tế cấp bách: trí tuệ nhân tạo đang phát triển nhanh hơn so với công tác quản trị văn hóa, làm gia tăng khoảng cách và nảy sinh những rủi ro mới, đồng thời cũng mang lại những cơ hội mạnh mẽ để củng cố sự đổi mới và khả năng thích ứng của văn hóa.

AI đang làm thay đổi cách thức văn hóa được tạo ra, chia sẻ và bảo tồn. Công nghệ này có thể mở rộng khả năng tiếp cận, bảo vệ di sản, khuếch đại các tiếng nói đa dạng và mở ra những khả năng sáng tạo mới. Tuy nhiên, nó cũng có thể làm trầm trọng thêm tình trạng bất bình đẳng, gia tăng định kiến, đẩy nhanh quá trình đồng nhất hóa văn hóa và làm tăng các chi phí môi trường.

Báo cáo chỉ ra các thách thức cốt lõi:

  • Tốc độ phát triển vượt xa khả năng quản trị: sự tăng tốc của AI vượt quá khả năng thích ứng của các hệ sinh thái văn hóa, đe dọa chủ quyền, tính đa nguyên và sự giám sát dân chủ;

  • Củng cố định kiến ​​và sự đồng nhất hóa: dữ liệu huấn luyện thiếu cân bằng và cơ chế cá nhân hóa bằng thuật toán làm tái diễn các khuôn mẫu định kiến ​​và thúc đẩy văn hóa đơn nhất;

  • Xâm phạm quyền văn hóa: thông qua việc khai thác dữ liệu văn hóa không được bảo hộ mà thiếu sự đồng ý, ghi nhận nguồn gốc hay đền bù, cũng như gạt bỏ các nền văn hóa thiểu số ra bên lề; và

  • Làm suy giảm khả năng sáng tạo và các kỹ năng: sự phụ thuộc quá mức vào AI làm suy yếu khả năng sáng tạo và năng lực tư duy của con người.

Báo cáo cũng nêu bật các cơ hội, đáng chú ý là:

  • Mở rộng khả năng sáng tạo và tiếp cận: bằng cách giảm bớt rào cản gia nhập và tạo điều kiện cho các hình thức sáng tạo mới;

  • Bảo vệ di sản văn hóa: thông qua các hoạt động phục dựng, bảo tồn, ứng phó sau thảm họa và gìn giữ các ngôn ngữ đang có nguy cơ mai một;

  • Tăng cường các ngành công nghiệp văn hóa và sáng tạo: việc tự động hóa các tác vụ thường nhật giúp giảm chi phí và nâng cao năng lực cạnh tranh cho các doanh nghiệp nhỏ; và

  • Thúc đẩy cơ hội học tập bình đẳng: các bảo tàng và cơ sở văn hóa giúp bồi đắp năng lực hiểu biết về AI, khả năng sáng tạo và tư duy phản biện.

Nhóm Chuyên gia Độc lập kêu gọi sự hợp tác toàn cầu và cơ chế quản trị bao trùm nhằm đảm bảo AI góp phần củng cố sự đa dạng văn hóa, tính công bằng và sự bền vững. Các phương pháp tiếp cận AI dựa trên quyền con người, các thực hành xanh, nền kinh tế sáng tạo công bằng và tương lai văn hóa bền vững cần đặt sự sáng tạo của con người và quyền văn hóa vào vị trí trung tâm của quá trình phát triển công nghệ.”

Tự do tải về bản dịch sang tiếng Việt của tài liệu có 115 trang tại địa chỉ:

https://www.dropbox.com/scl/fi/9x9wrl598ivv4k96pd8ys/CULTAI_Report-of-the-Independent-Expert-Group-on-Artificial-Intelligence-and-Culture-final-online-version-1-1-_Vi-14092026.pdf?rlkey=yd4qnb919frc45qzms6p4f6am&st=mdomobic&dl=0

Xem thêm:

Blogger: Lê Trung Nghĩa

letrungnghia.foss@gmail.com
Thứ Năm, 24 tháng 9, 2026

‘Liệu các bot AI có đang đẩy di sản văn hóa vào môi trường phi trực tuyến?’ - bản dịch sang tiếng Việt


‘Liệu các bot AI có đang đẩy di sản văn hóa vào môi trường phi trực tuyến?’ - bản dịch sang tiếng Việt

Là bản dịch sang tiếng Việt tài liệu của Michael Weinberg, do GLAM-E Lab xuất bản tháng 6/2025, giấy phép CC BY 4.0.

“Giới thiệu

Vào cuối năm 2024, bắt đầu xuất hiện những báo cáo lẻ tẻ từ các bộ sưu tập di sản văn hóa trực tuyến riêng lẻ. Các báo cáo này mô tả tình trạng máy chủ và hệ thống lưu trữ bị quá tải – và đôi khi gặp sự cố – ​​do sự tấn công dồn dập của các chương trình tự động (bot). Các bot này được cho là đang thu thập toàn bộ dữ liệu từ các bộ sưu tập để xây dựng tập dữ liệu huấn luyện cho các mô hình trí tuệ nhân tạo (AI). Hoạt động này gây áp lực quá lớn lên các hệ thống vốn được thiết kế để duy trì sự hiện diện trực tuyến của các bộ sưu tập đó.

Mặc dù đáng lo ngại, nhưng chưa thể khẳng định ngay liệu những báo cáo này có phản ánh một xu hướng rộng lớn hơn hay không. Liệu chúng có đại diện cho trải nghiệm của đa số các bộ sưu tập trực tuyến? Chúng chỉ là những trường hợp cá biệt? Hay là những dấu hiệu cảnh báo sớm?

GLAM-E Lab đã công bố báo cáo này nhằm giải đáp các câu hỏi trên và bắt đầu phác họa bức tranh toàn cảnh lớn hơn. Báo cáo tập trung đặc biệt vào các bộ sưu tập đã được số hóa và dữ liệu liên quan đến các tổ chức GLAM – bao gồm Phòng trưng bày (Galleries), Thư viện (Libraries), Cơ quan lưu trữ (Archives) và Bảo tàng (Museums).

Vào tháng 4 năm 2025, GLAM-E Lab đã gửi một bản khảo sát ngắn qua các danh sách thư điện tử (listserv) dành cho những người làm việc trong lĩnh vực di sản và công nghệ tại các tổ chức GLAM, bao gồm cả những người trong và ngoài giới học thuật. Cộng đồng này mang tính quốc tế và bao gồm các cơ sở với quy mô đa dạng, từ các cơ quan lưu trữ quốc gia hàng đầu cho đến các bảo tàng địa phương.

Chúng tôi đã đặt câu hỏi cho các tổ chức sở hữu bộ sưu tập trực tuyến – bất kể các bộ sưu tập đó có được cấp phép mở hay không – về trải nghiệm của họ liên quan đến các bot thu thập dữ liệu để huấn luyện AI. Các câu hỏi tập trung vào tác động kỹ thuật mà các bot gây ra (hoặc không gây ra) đối với cơ sở hạ tầng trực tuyến của họ. Mục tiêu của chúng tôi là tìm hiểu xem liệu những báo cáo ban đầu về sự cố có đại diện cho tình hình chung của cộng đồng GLAM hay không, đồng thời hiểu rõ hơn và chi tiết hơn về các vấn đề kỹ thuật mà các bộ sưu tập mở đang gặp phải do bot, và cuối cùng là bắt đầu định hình các giải pháp khả thi….”

Tự do tải về bản dịch sang tiếng Việt của tài liệu có 51 trang tại địa chỉ:

https://www.dropbox.com/scl/fi/6nh8ug1t3dxgw44li7eah/Are_AI_Bots_Knocking_Cultural_Heritage_Offline_Vi-02092026.pdf?rlkey=yg2o03bpptkxu429m5p1kbbxn&st=wux1i4je&dl=0

Xem thêm:

Blogger: Lê Trung Nghĩa

letrungnghia.foss@gmail.com